Das Problem höre ich immer mal wieder an der Hotline. Der Nutzer hat vorhandene Geometrien einer gemeinsamen Grenze mit vielen Stützstellen, die er nicht alle nachdigitalisieren will und kann. Insbesondere bei Kurven kann die Anzahl der Stützstellen schnell mal sehr hoch, z. B. > 100 werden. Mit der Funktion „Spurverfolgung“ steht Euch in QGIS eine wunderbare Möglichkeit zur Verfügung, diesen an sich sehr aufwendigen Prozess auf genau zwei Klicks, nämlich den Anfangs- und den Endpunkt zu reduzieren und eine topologisch exakte Linie digitalisieren zu lassen. Im Youtube-Video „QGIS 3.28 – Entlang Geometrien anderer Layer Digitalisieren“ [1] der Marshal Mappers wird die Funktion wunderbar nachvollziehbar erklärt. Einfach mal schauen und dann Happy Digitizing!
Weitere Anleitungen zum Thema „qgis trace tracking“ findet Ihr unter [2], [3]
Screenshot 1: Die Landuse- und Landcover-Karten (LULC) von HeiGIT auf der interaktiven Plattform osmlanduse.org [2]
Vielleicht kennt Ihr das Problem: Während topografische Inhalte wie beispielsweise Straßen und Gebäude in OpenStreetMap extrem detailliert eingetragen sind, weisen Flächeninformationen (Landnutzung wie Felder der Wälder) oft große Lücken auf. Zudem verschwimmen im OSM-Tagging-System häufig die Grenzen zwischen tatsächlicher Landnutzung (Landuse) und der physischen Bodenbedeckung (Landcover).
OSM4EO (OpenStreetMap for Earth Observation) ist ein wissenschaftliches Projekt und Framework, das von Dr. Michael Schultz und dem Heidelberger Institut für GeoinformationstechnologieHeiGIT [1] bzw. der Universität Heidelberg entwickelt wurde. Das Hauptziel von OSM4EO ist es, die Daten von OpenStreetMap (OSM) mit Satellitenfernerkundungsdaten (wie den Copernicus-Sentinel-Satelliten der ESA) zu fusionieren. Dadurch werden lückenlose, hochauflösende Landuse- und Landcover-Karten (LULC) generiert. Das Projekt nutzt Deep Learning (Deep Residual Convolutional Neural Networks), um die Lücken zu füllen. Dabei dienen bestehende, verifizierte OSM-Flächen als Trainingsdaten für die KI, um Oberflächenstrukturen auf Satellitenbildern zu erkennen. Das Modell prognostiziert anschließend die fehlenden Flächenbedeckungen flächendeckend.
Screenshot 2: Die Landuse- und Landcover-Karten (LULC) von HeiGIT ins QGIS über den Geobasis_Loader eingefügt [4]
Wo findet man die Daten und wie kann darauf zugegriffen werden?
WebGIS-Plattform: Die Ergebnisse und prognostizierten Schichten (z. B. der Layer osmlanduse:osm4eo) sind direkt auf der interaktiven Plattform osmlanduse.org [2] einsehbar
Daten-Download: Die fertigen LULC-Datensätze (z. B. für die gesamte Europäische Union als GeoTIFF) stehen Forschern und Entwicklern frei über das Repositorium HeiData zur Verfügung.
Quellcode & Modelle: Der Python-Quellcode für die Deep-Learning-Methodik sowie vortrainierte Modelle für verschiedene EU-Länder sind auf GitHub (schultzheidelberg) [5] gehostet.
Übrigens: Seit gestern sind diese Layer auch im QGIS über der Geobasis_Loader [4], Katalog 3 (Welt) verfügbar.
(Hinweis: Die Erstellung dieses Beitrages wurde durch KI unterstützt, die Verantwortung liegt beim Autor)
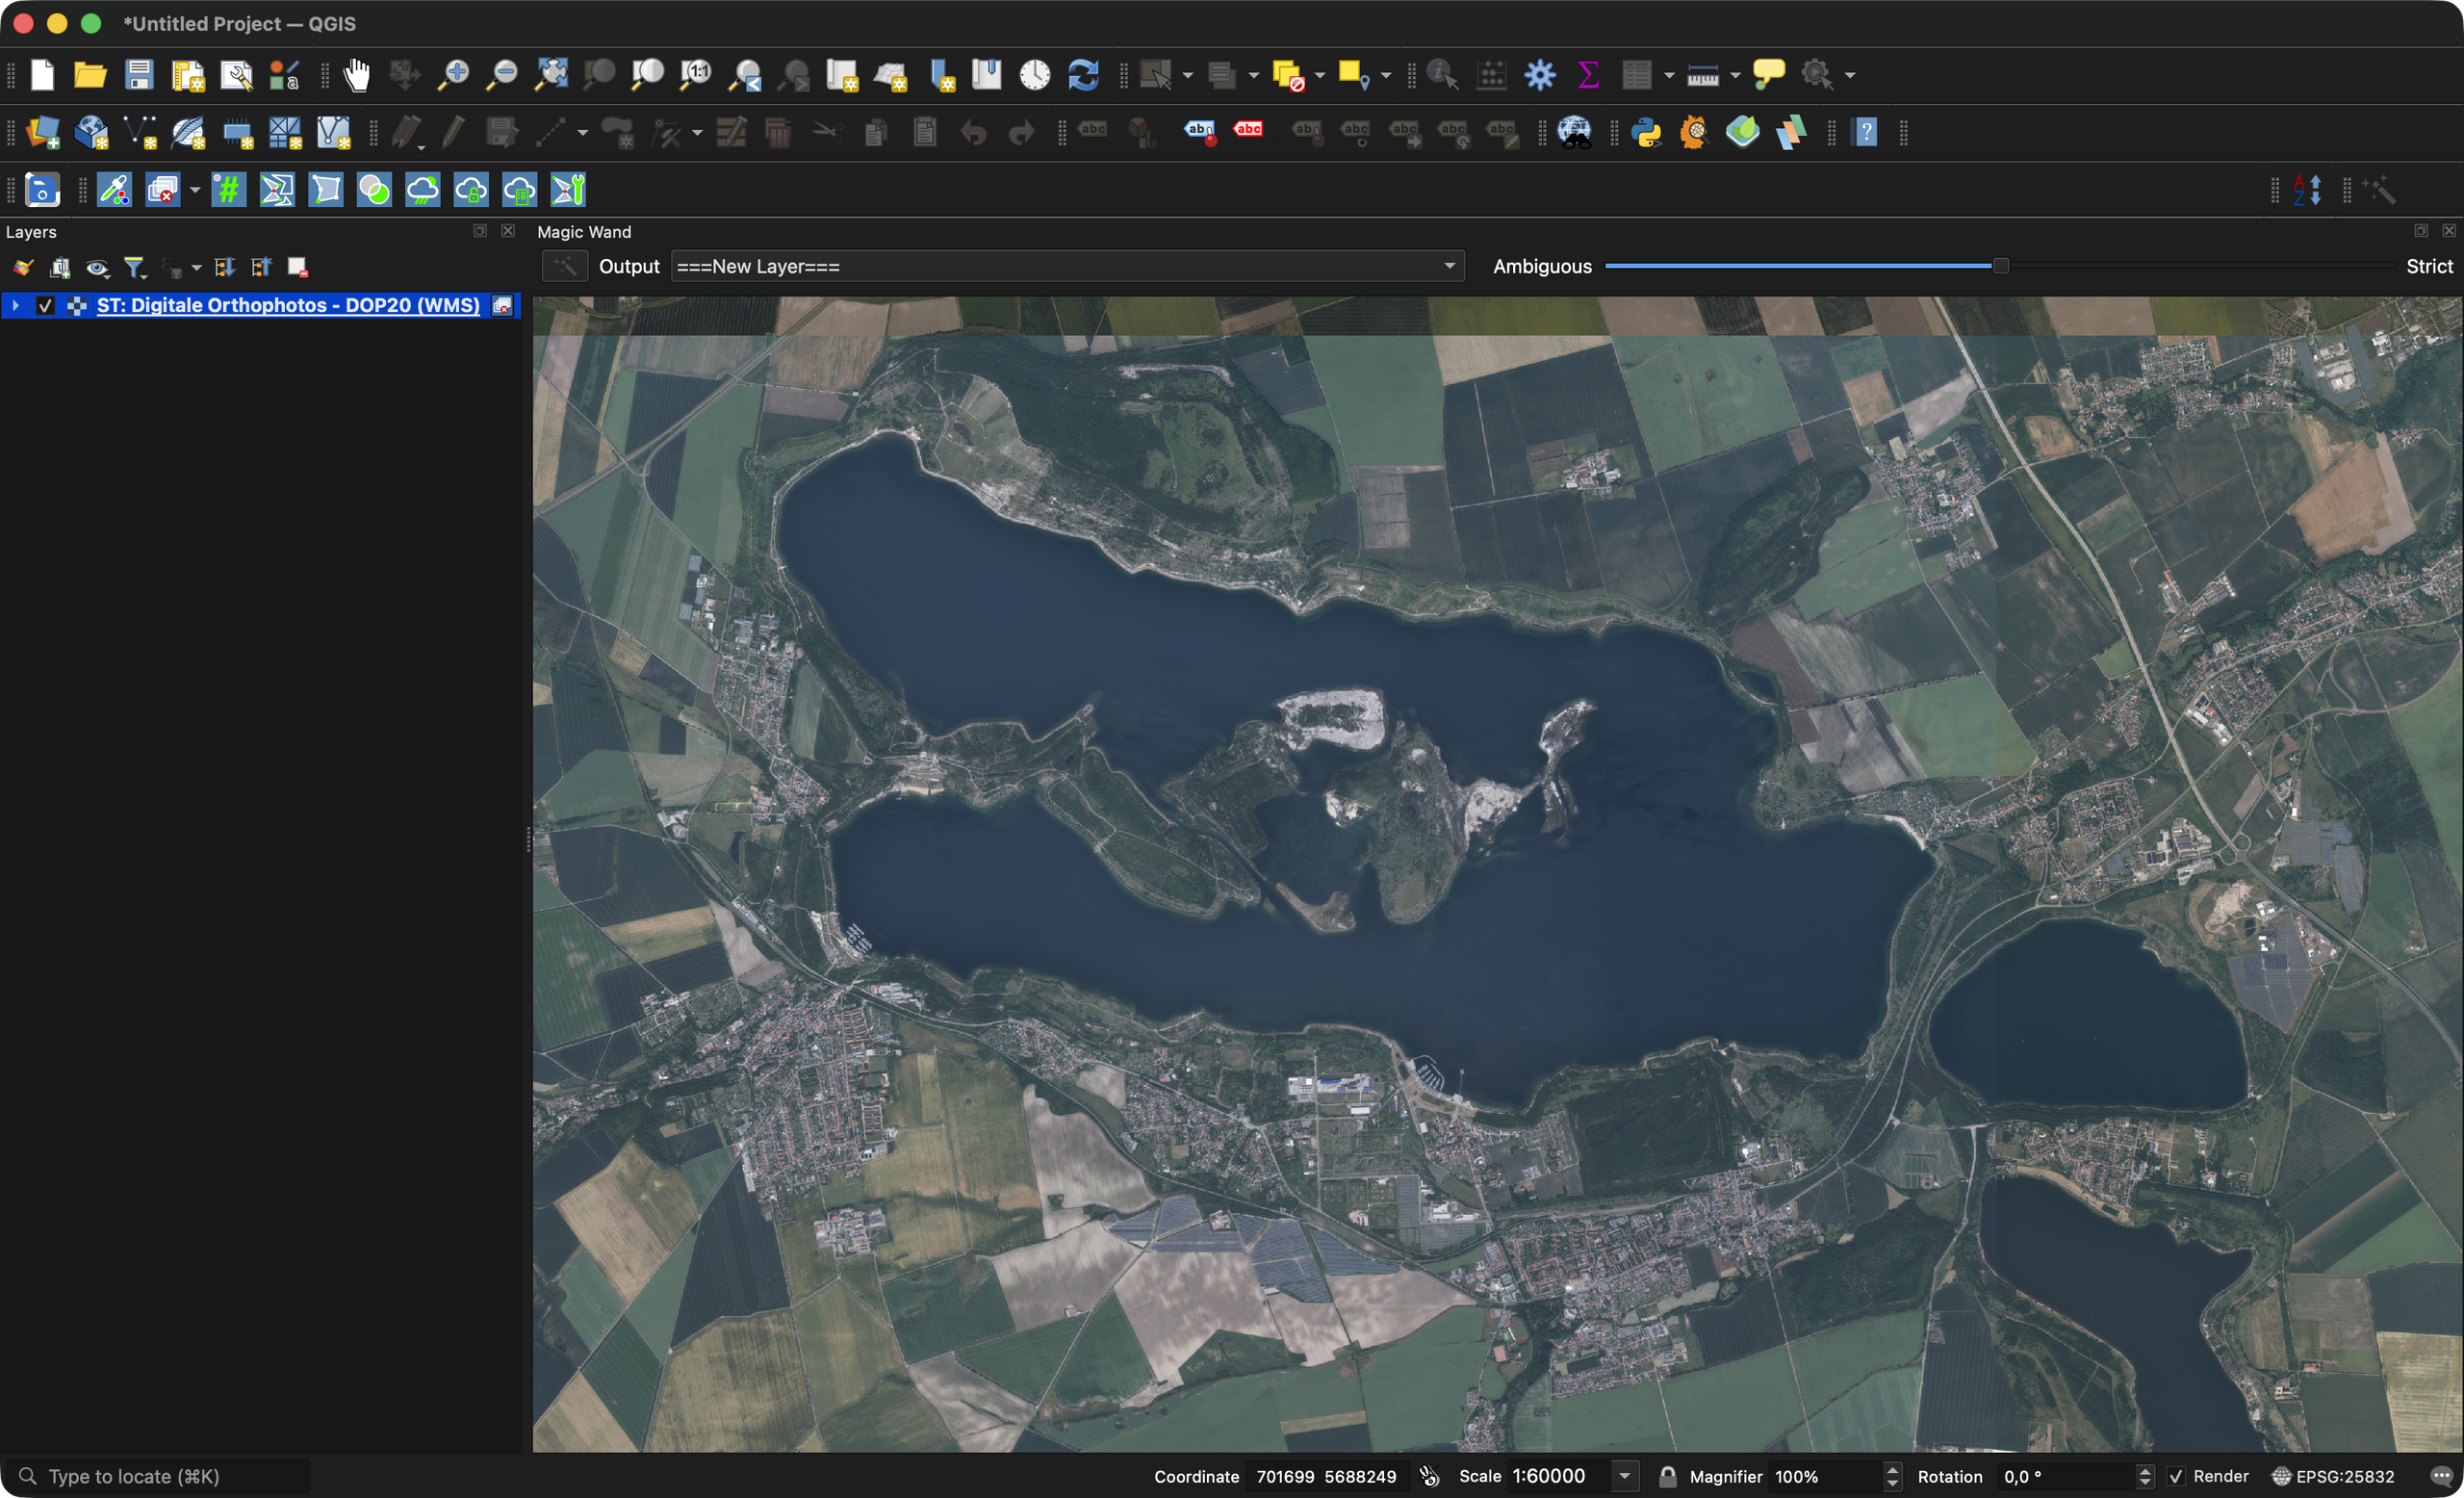
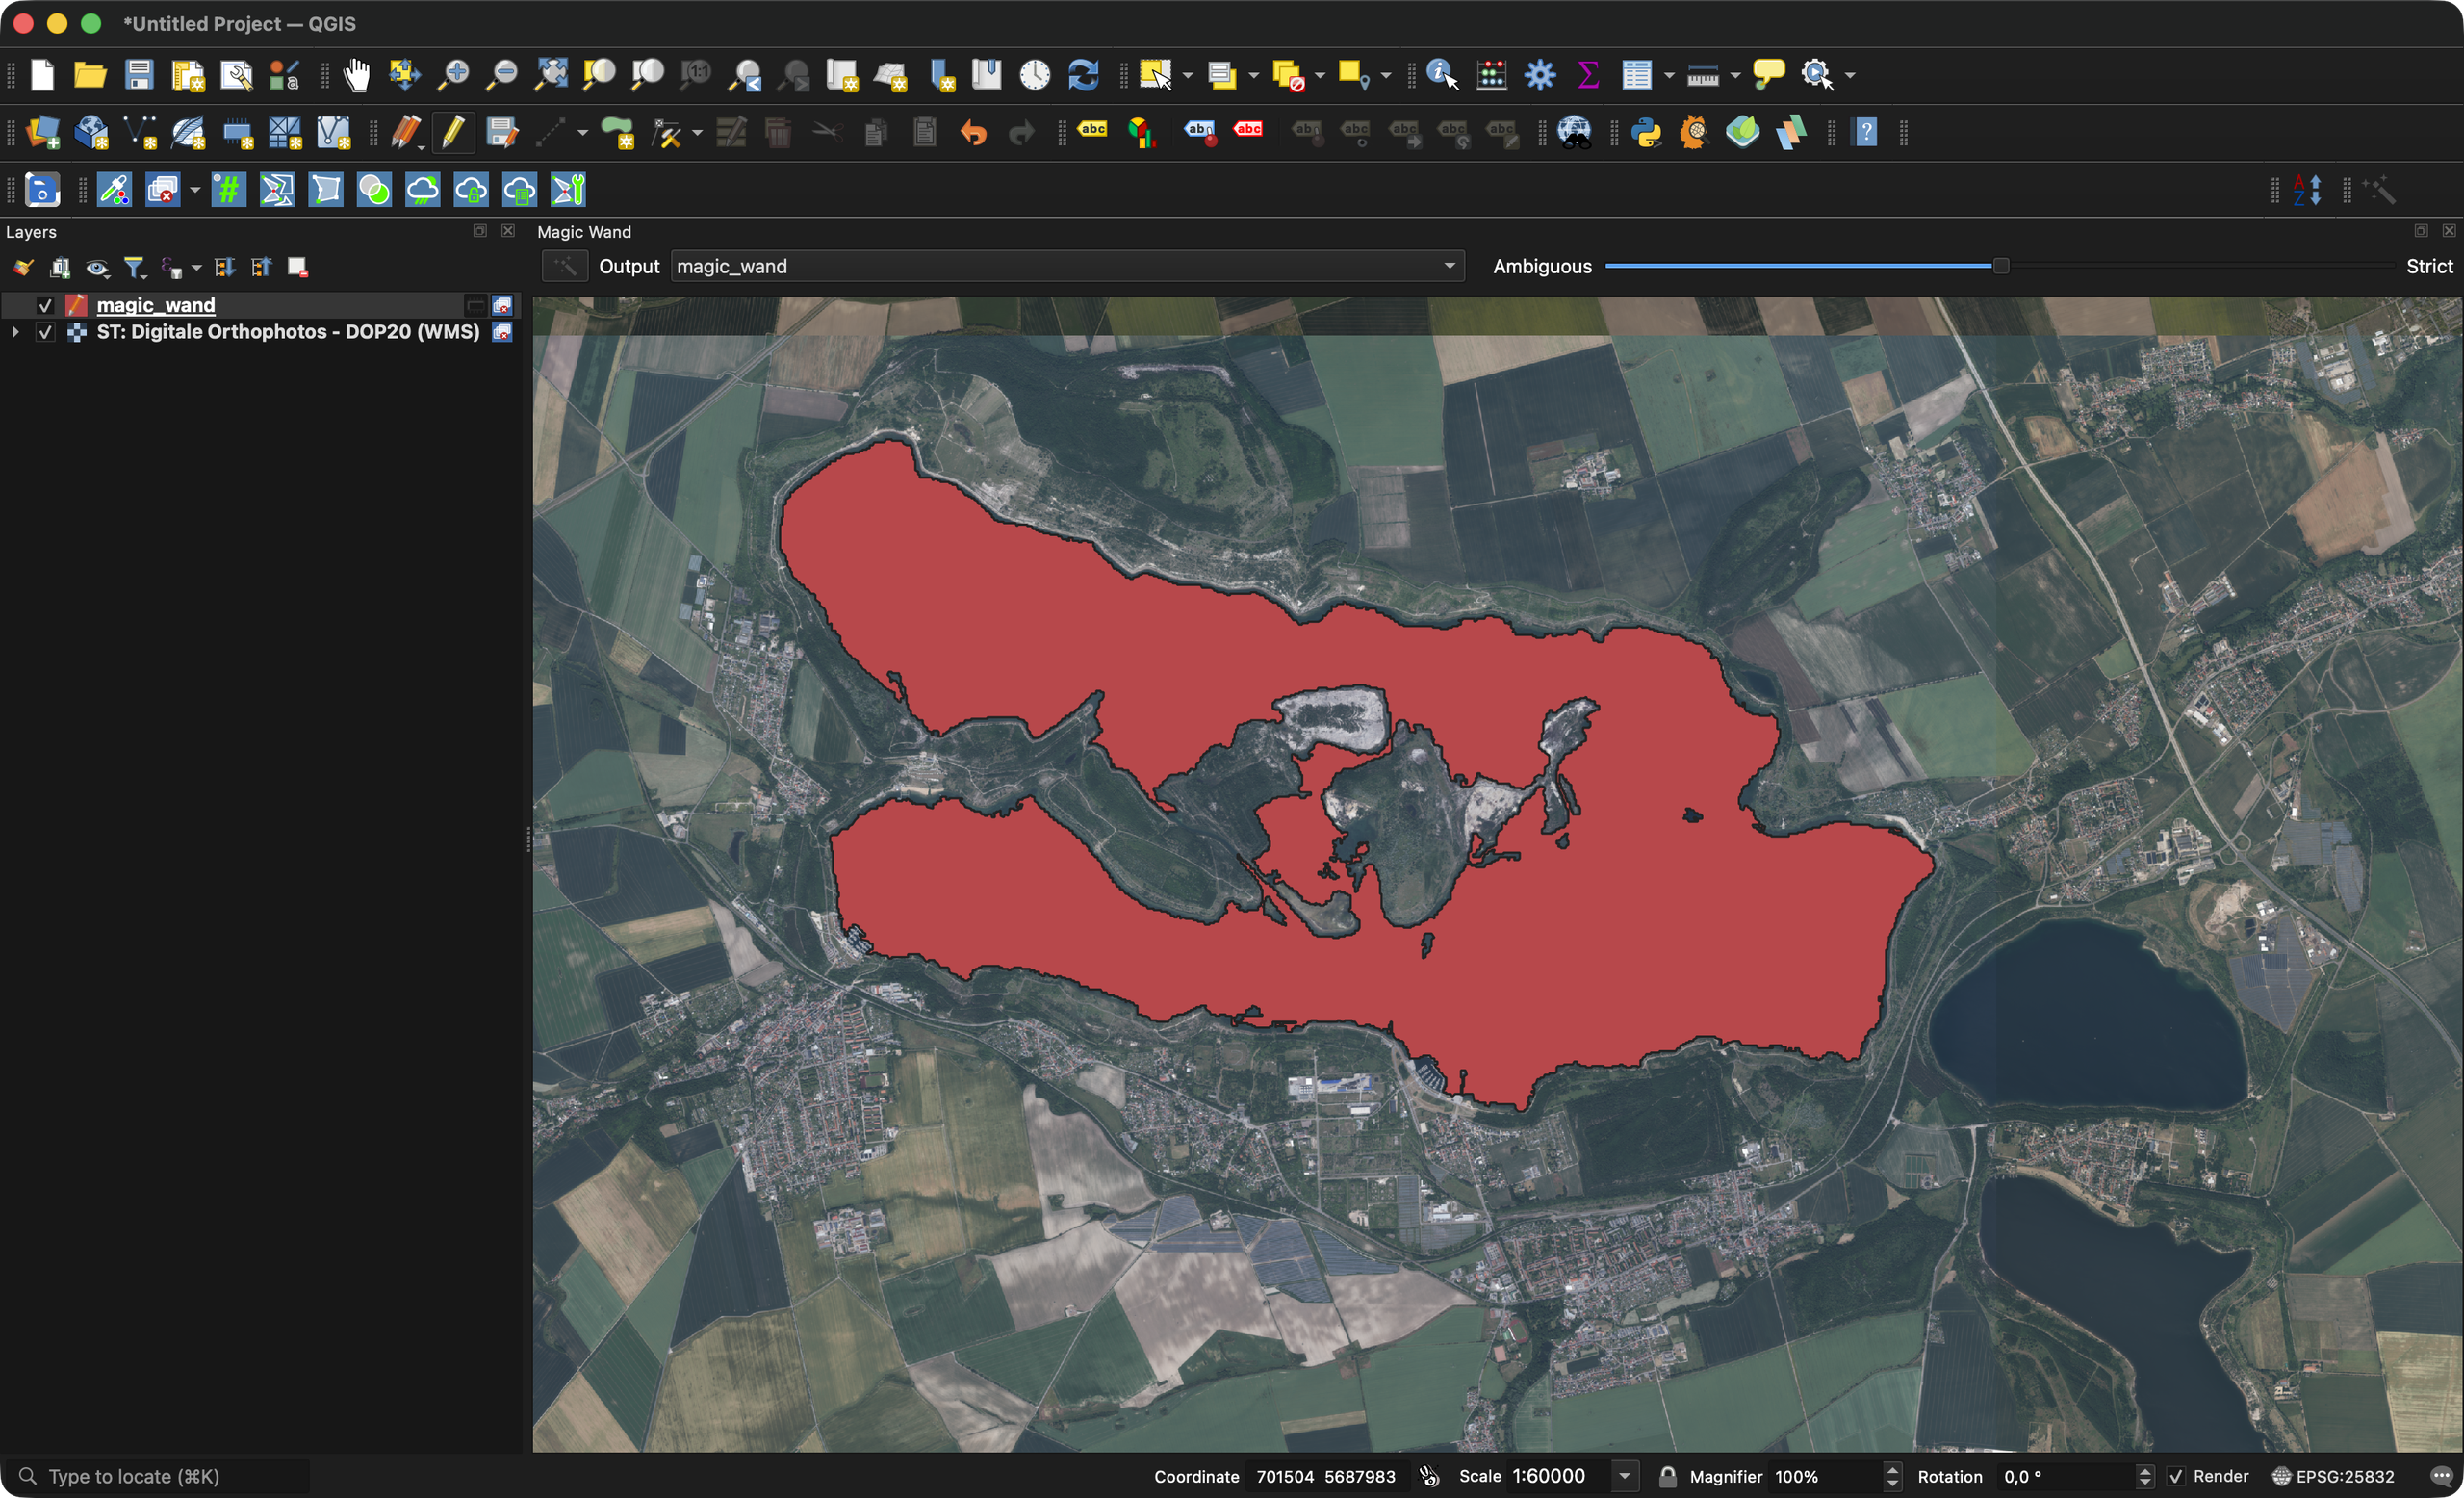
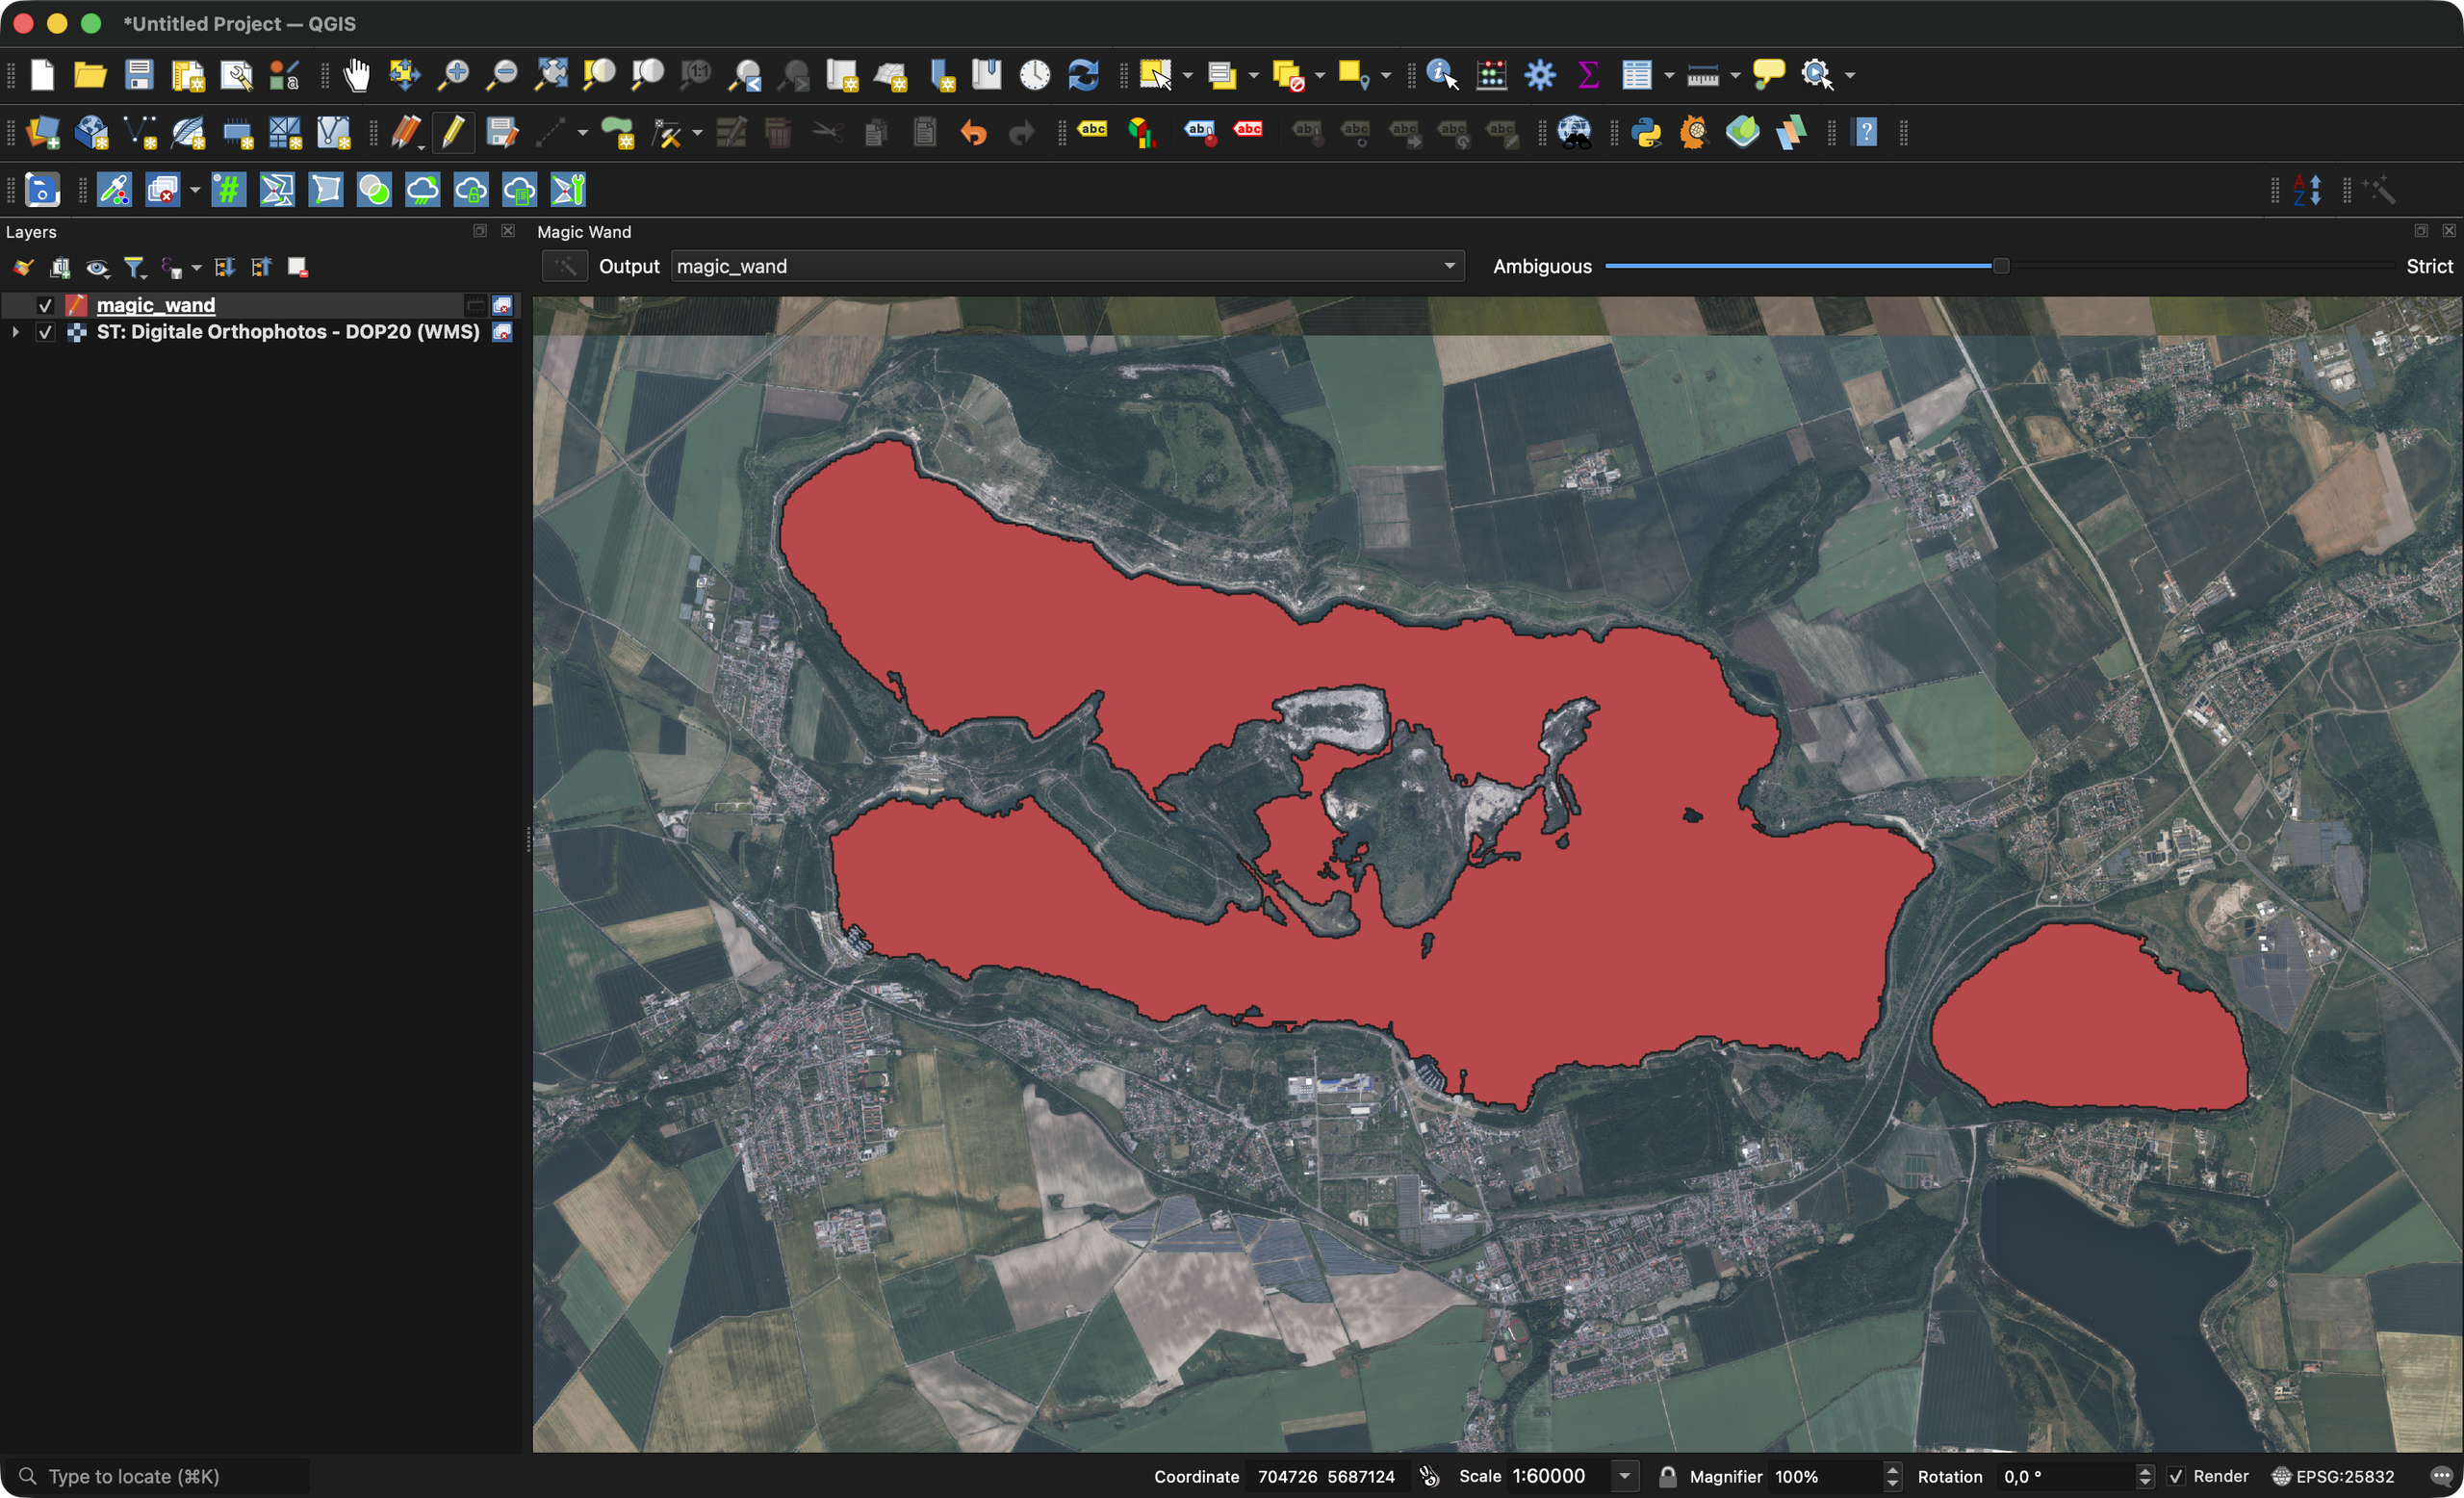
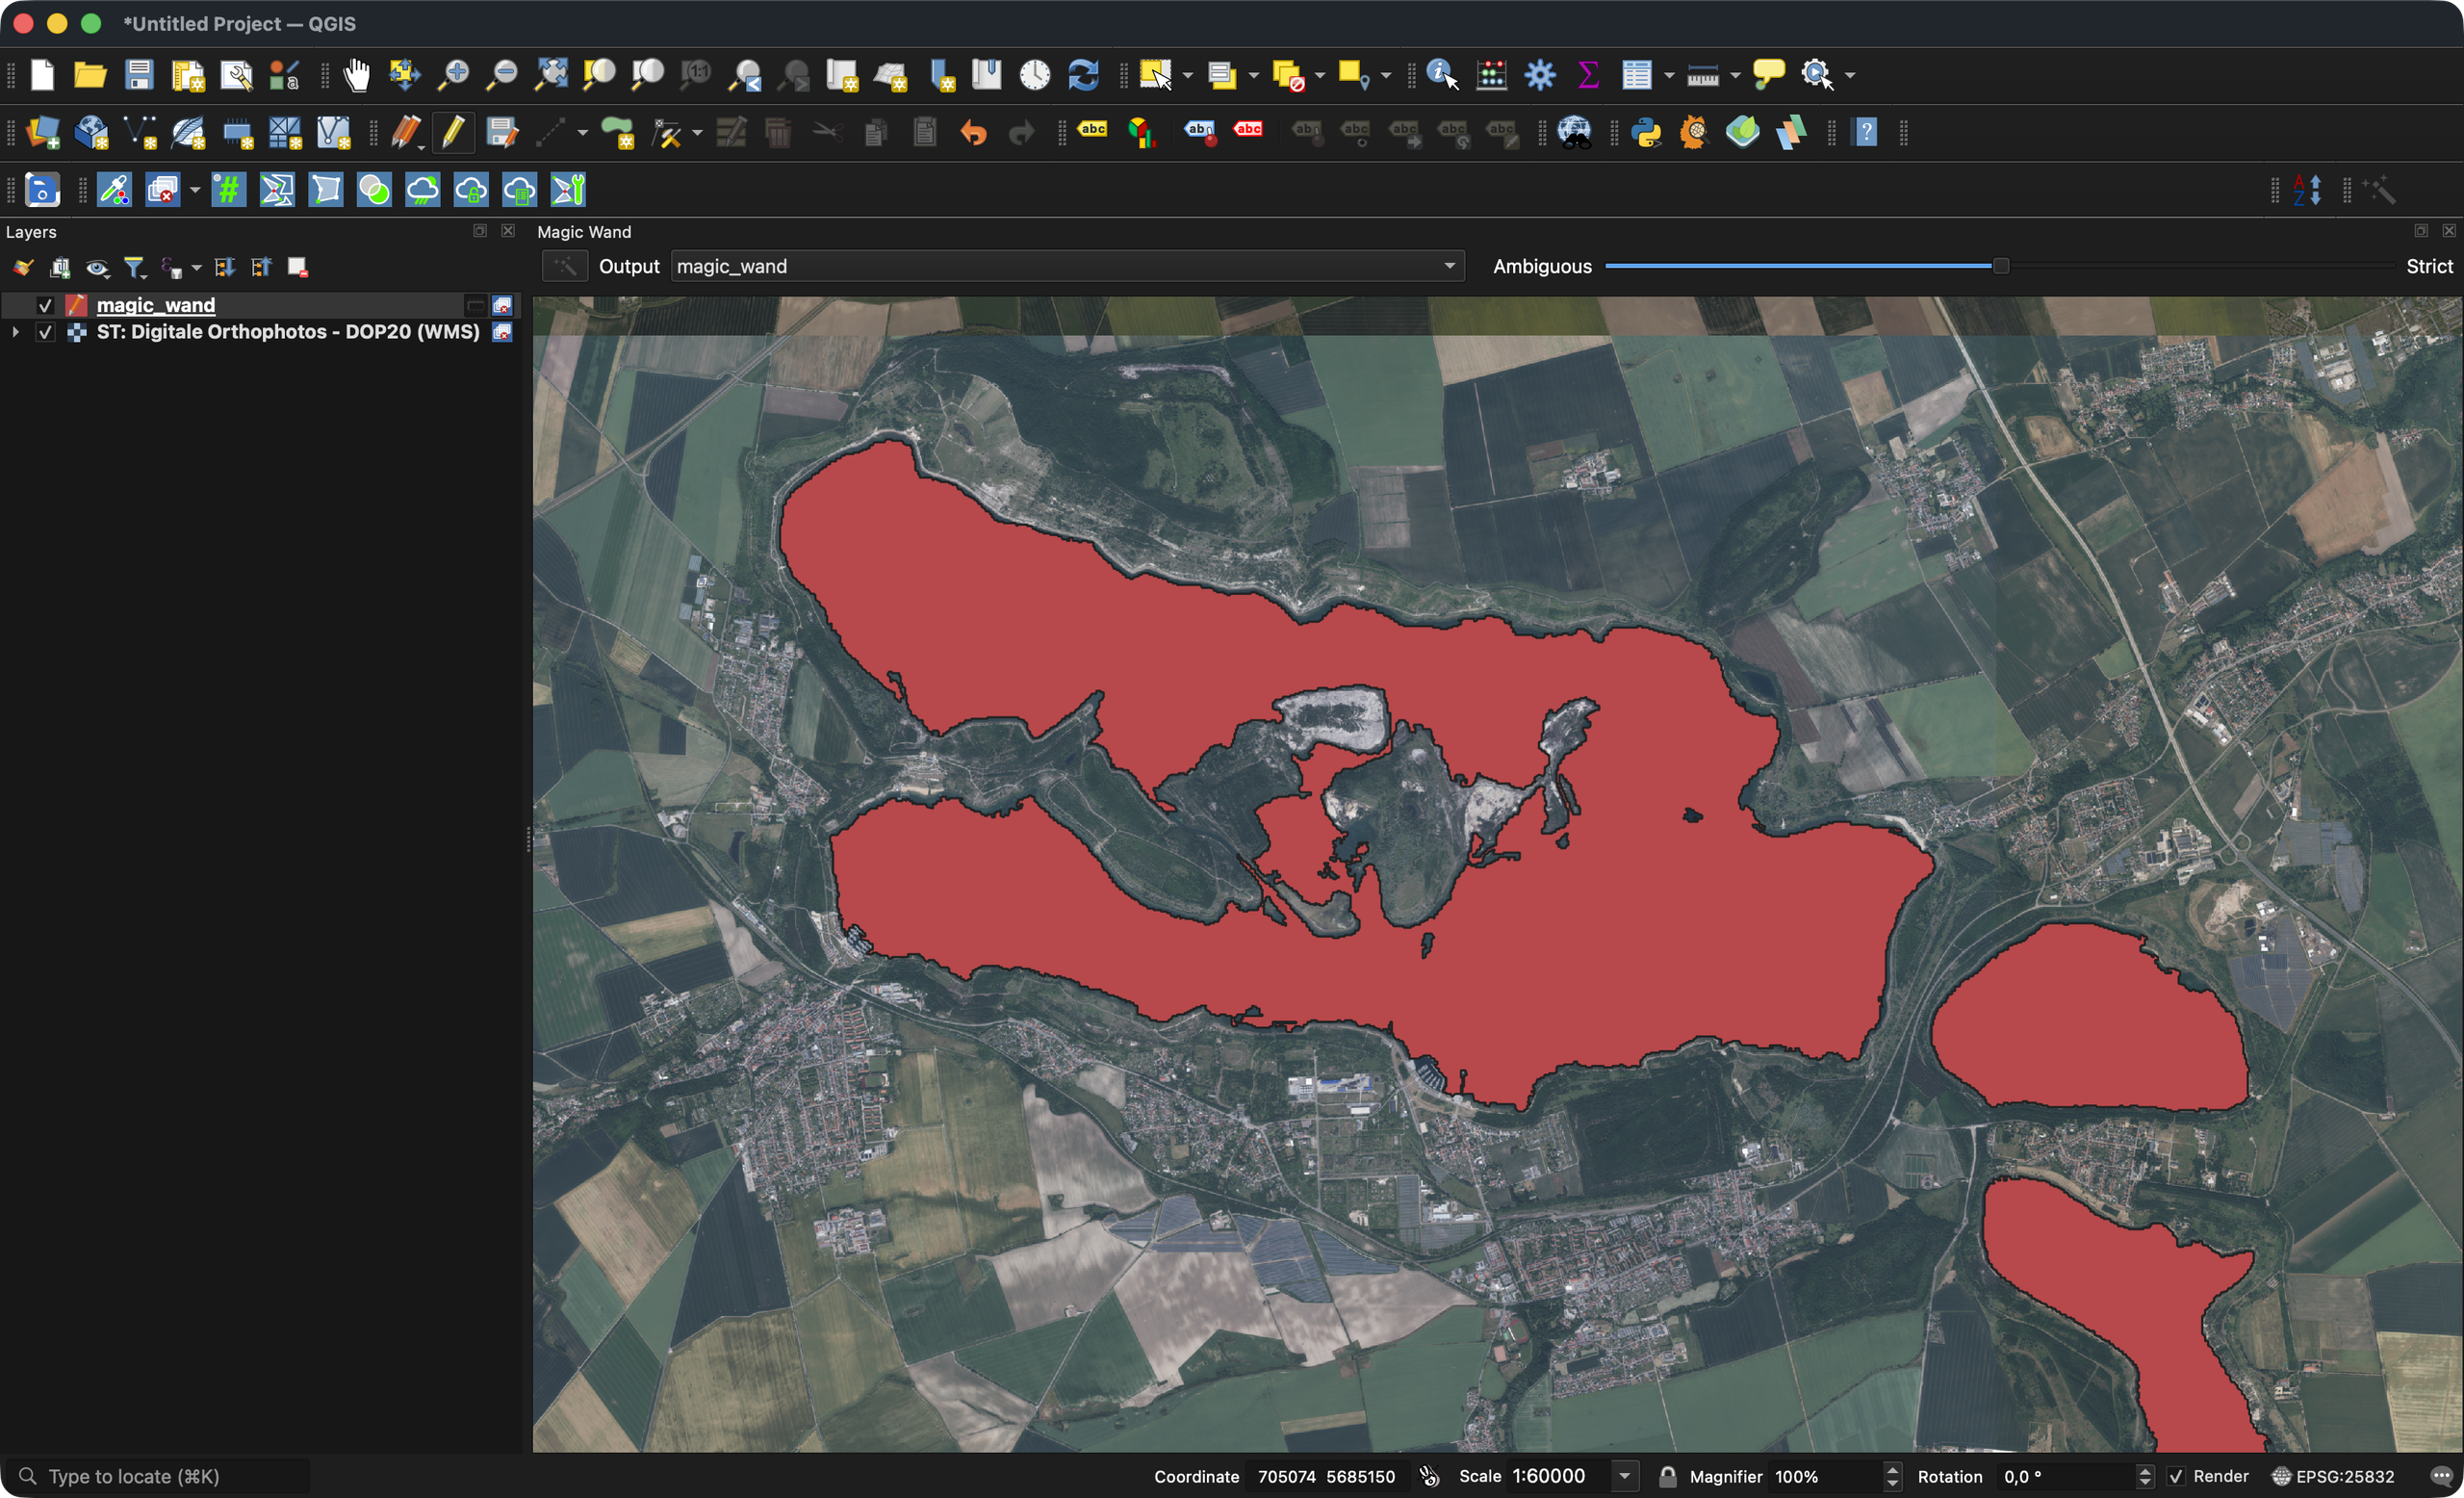
In Grafikprogrammen findet man ihn überall, den Zauberstab, ein Werkzeug, dass mit einem Klick Bereiche (ungefähr) gleicher Farbe markiert. Nun gibt es ein solches Werkzeug auch in QGIS, mit dem Plugin „Magic Wand“ [1] von Kanahiro. In wirklich wenigen Sekunden könnt Ihr Polygone mit recht guter Genauigkeit erzeugen. Aus meiner Sicht war es nie einfacher, im GIS Massendaten zu erfassen. Ein umfangreiches Tutorial findet Ihr in „Magic Wand: crea polígonos automáticamente en QGIS a partir del canvas“ [2] von Aurelio Morales [3] und auf GitHub [4]. Ich habe das Plugin natürlich gleich mal ausprobiert, mein Testgebiet war der Geiseltalsee [5]. Es hat ausgezeichnet funktioniert, die Erfassungszeit der drei Polygone lag bei ca. 15 Sekunden. „Magic Wand“ [1] bekommt von mir eine absolute Empfehlung, 5 von 5 Sterne!
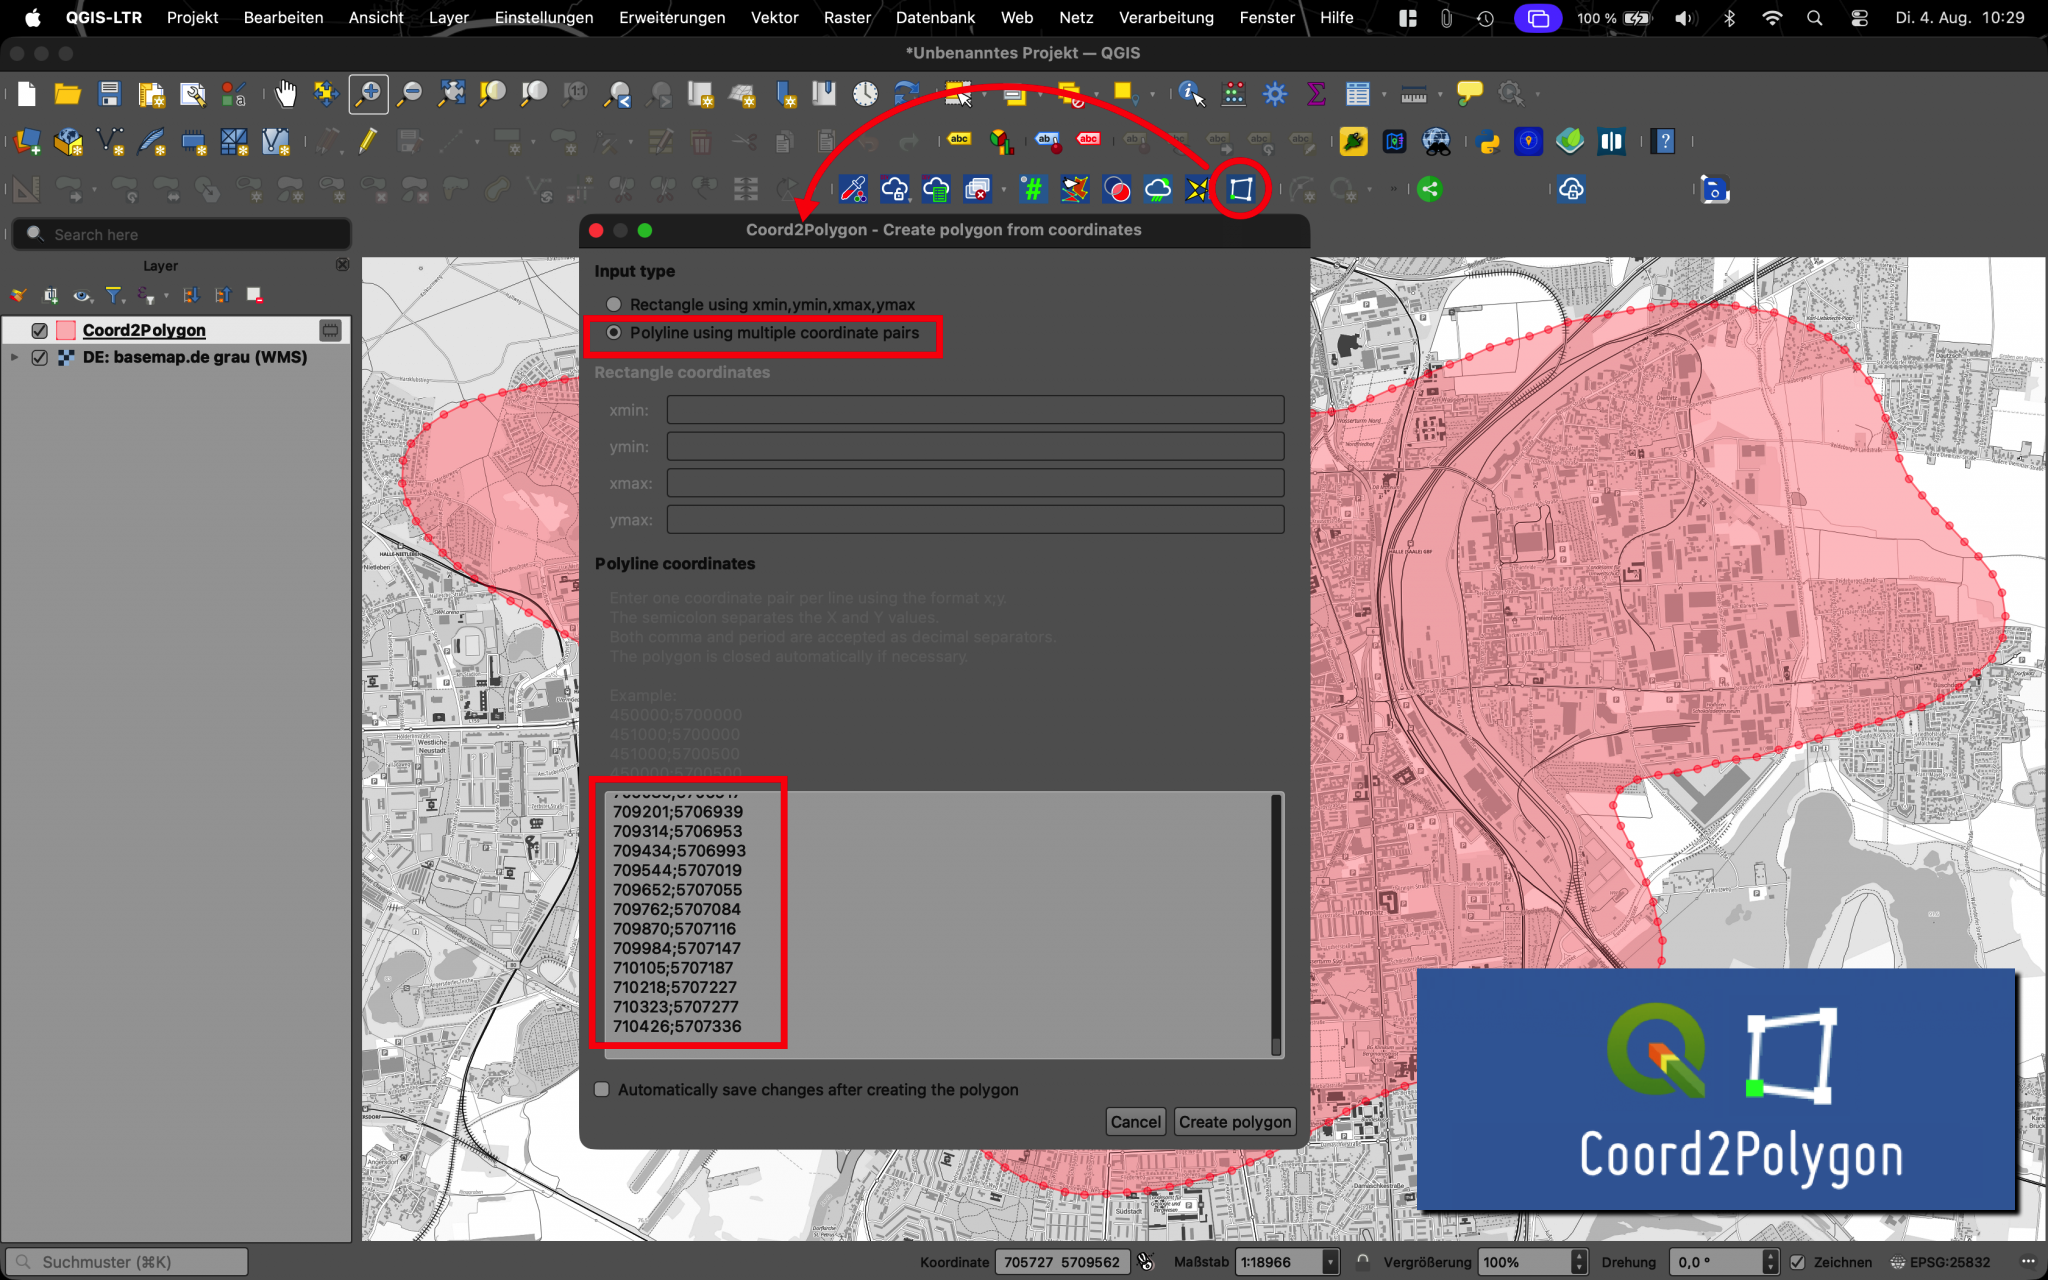
Screenshot 1: Koordinatenpaare zur einem Polygon importiert
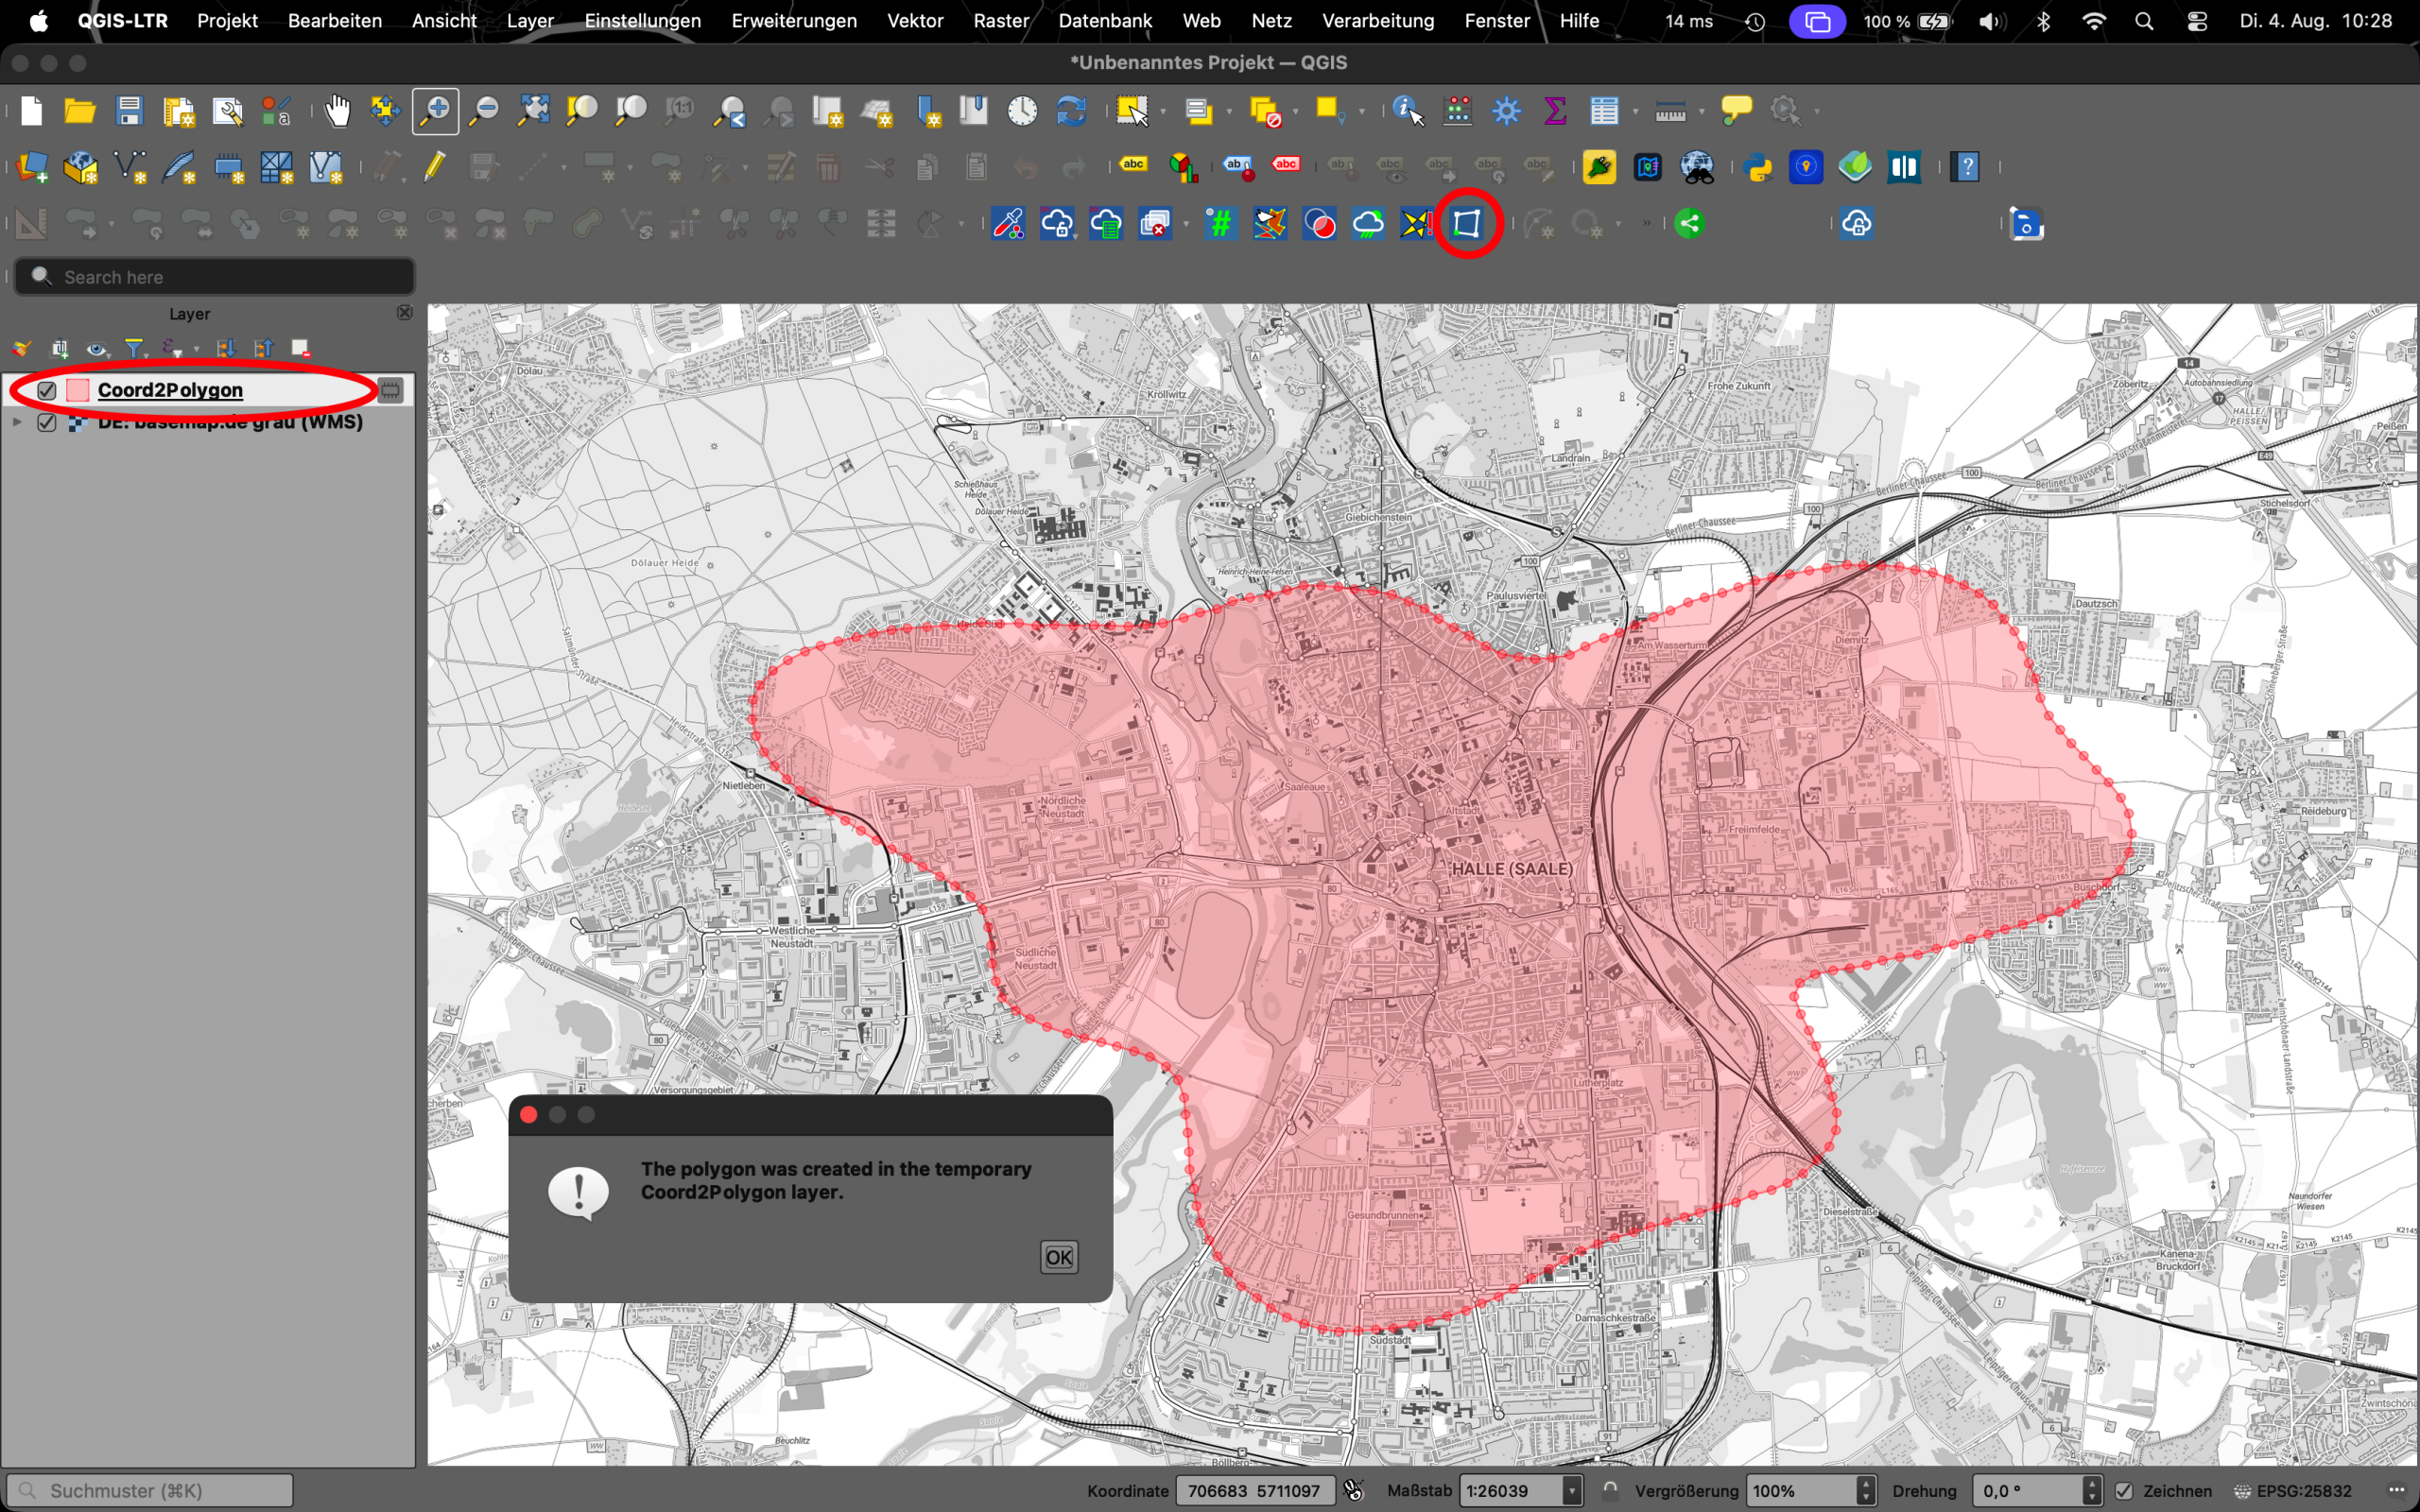
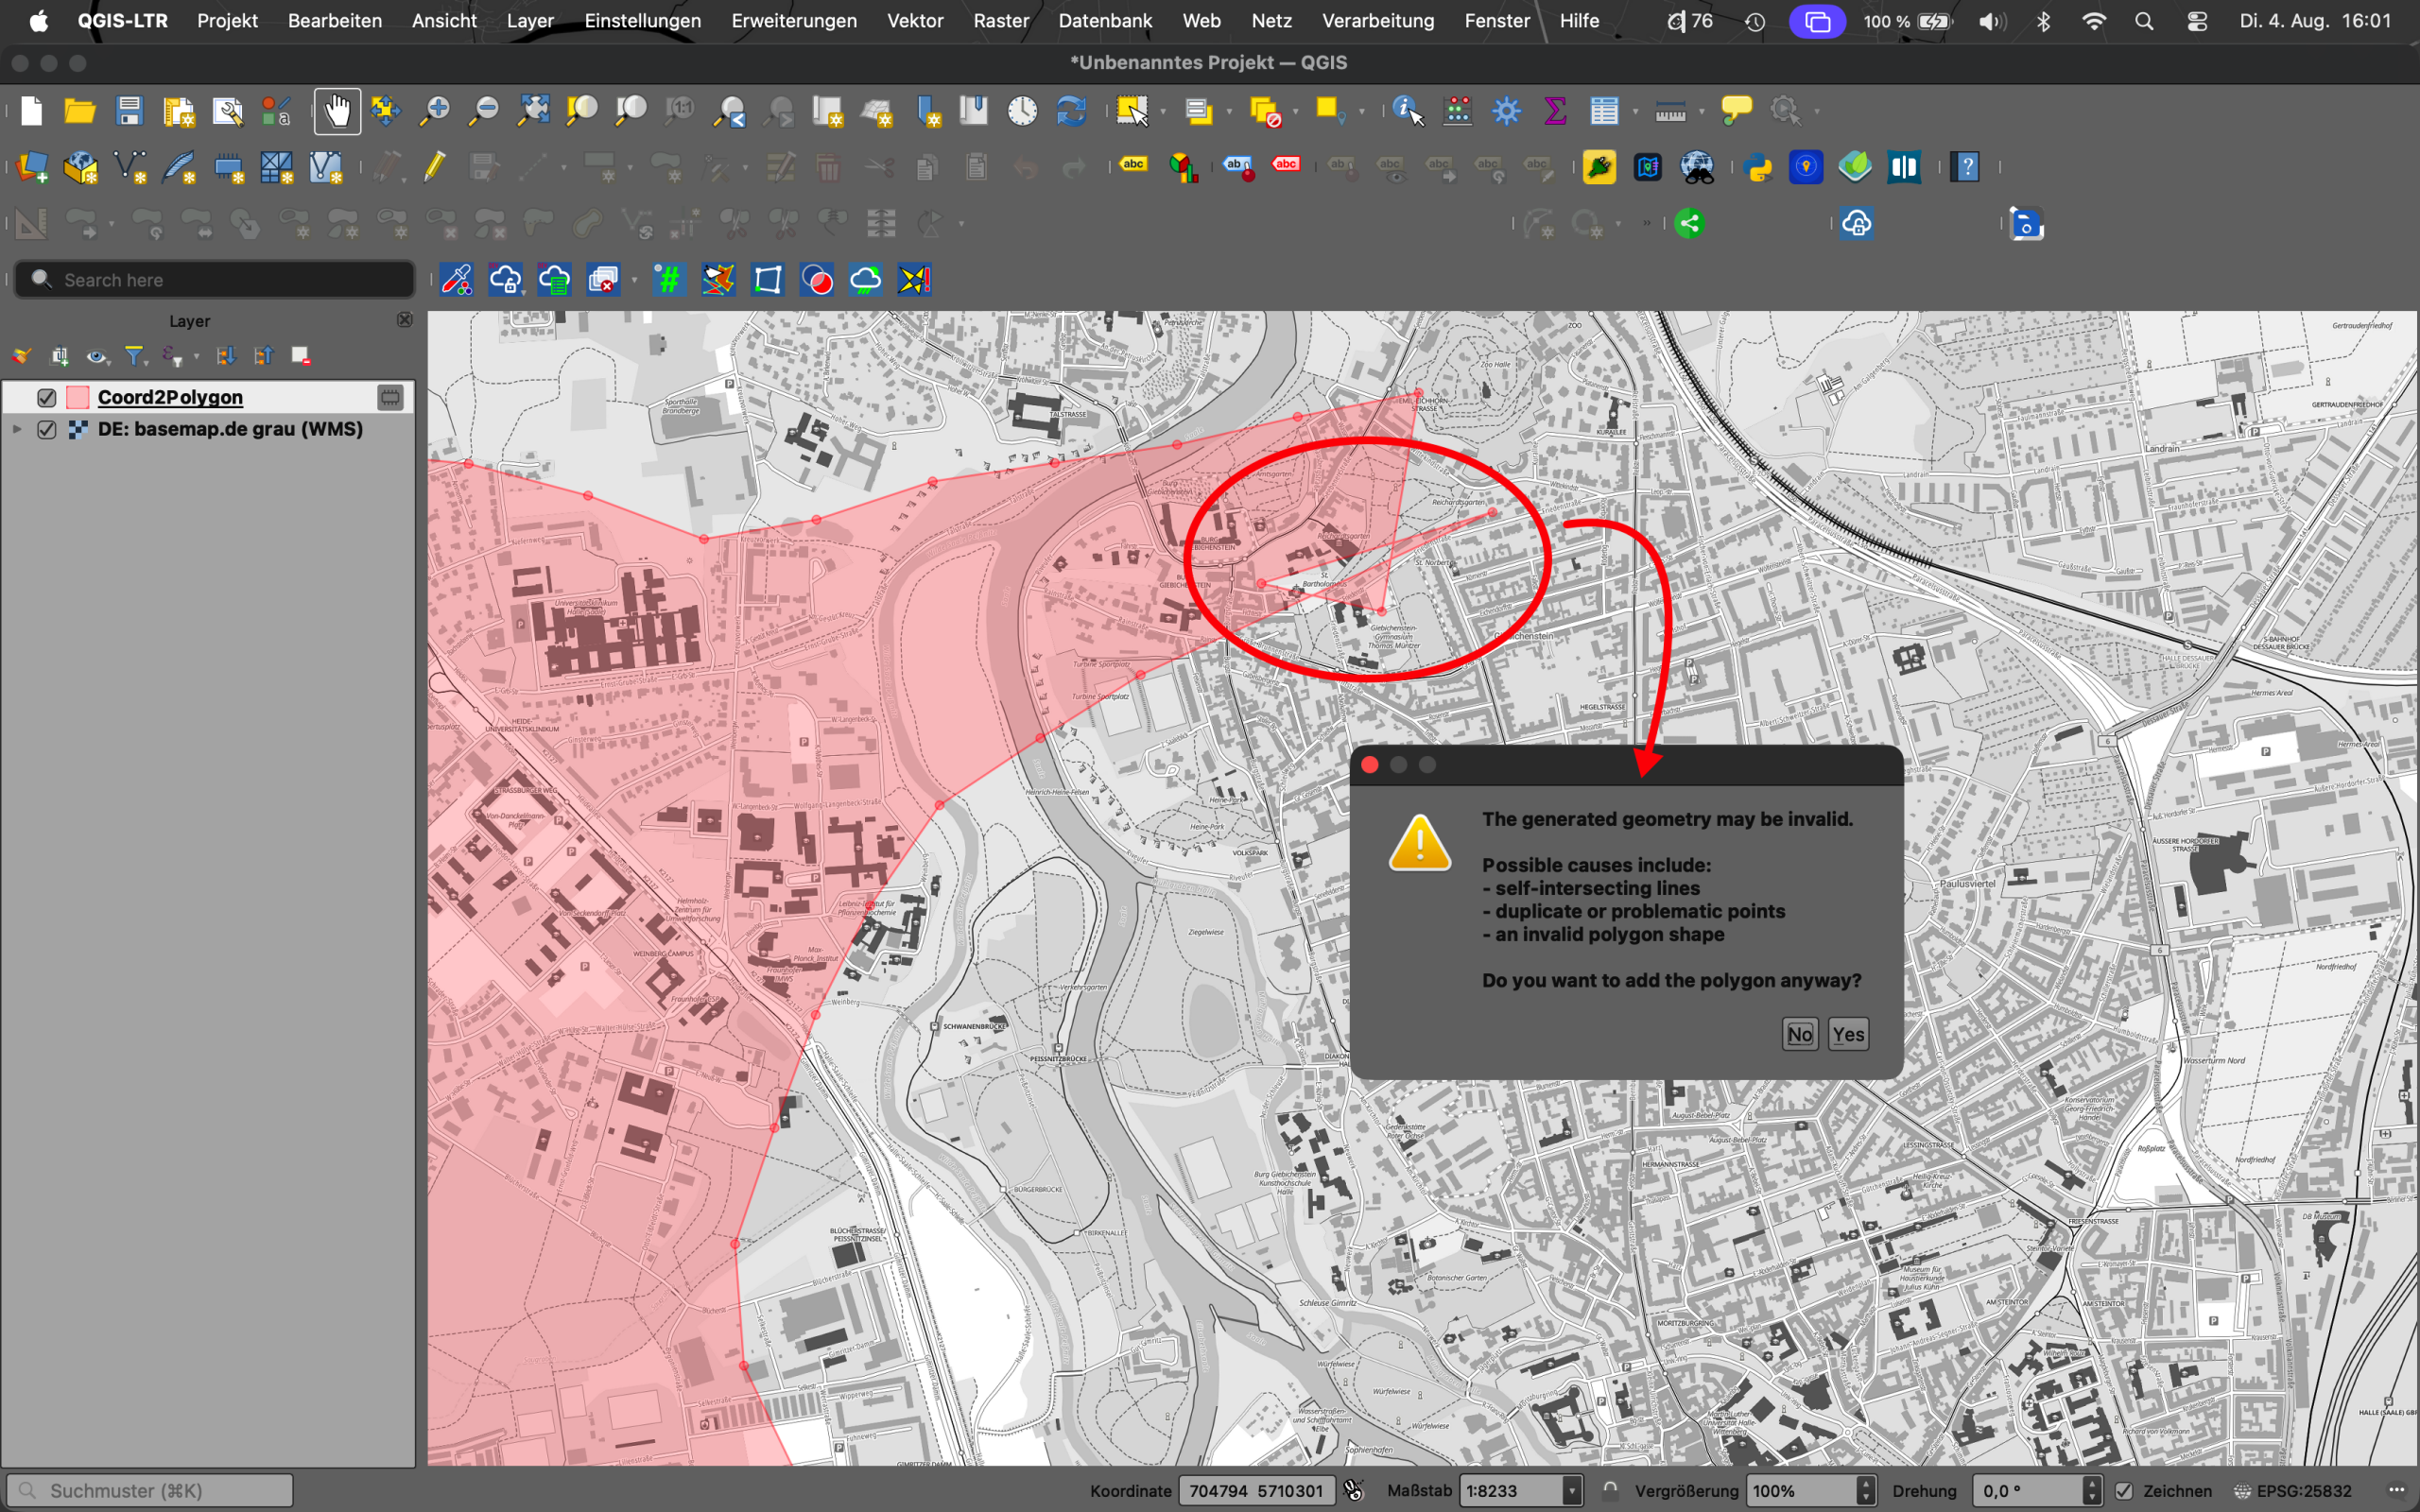
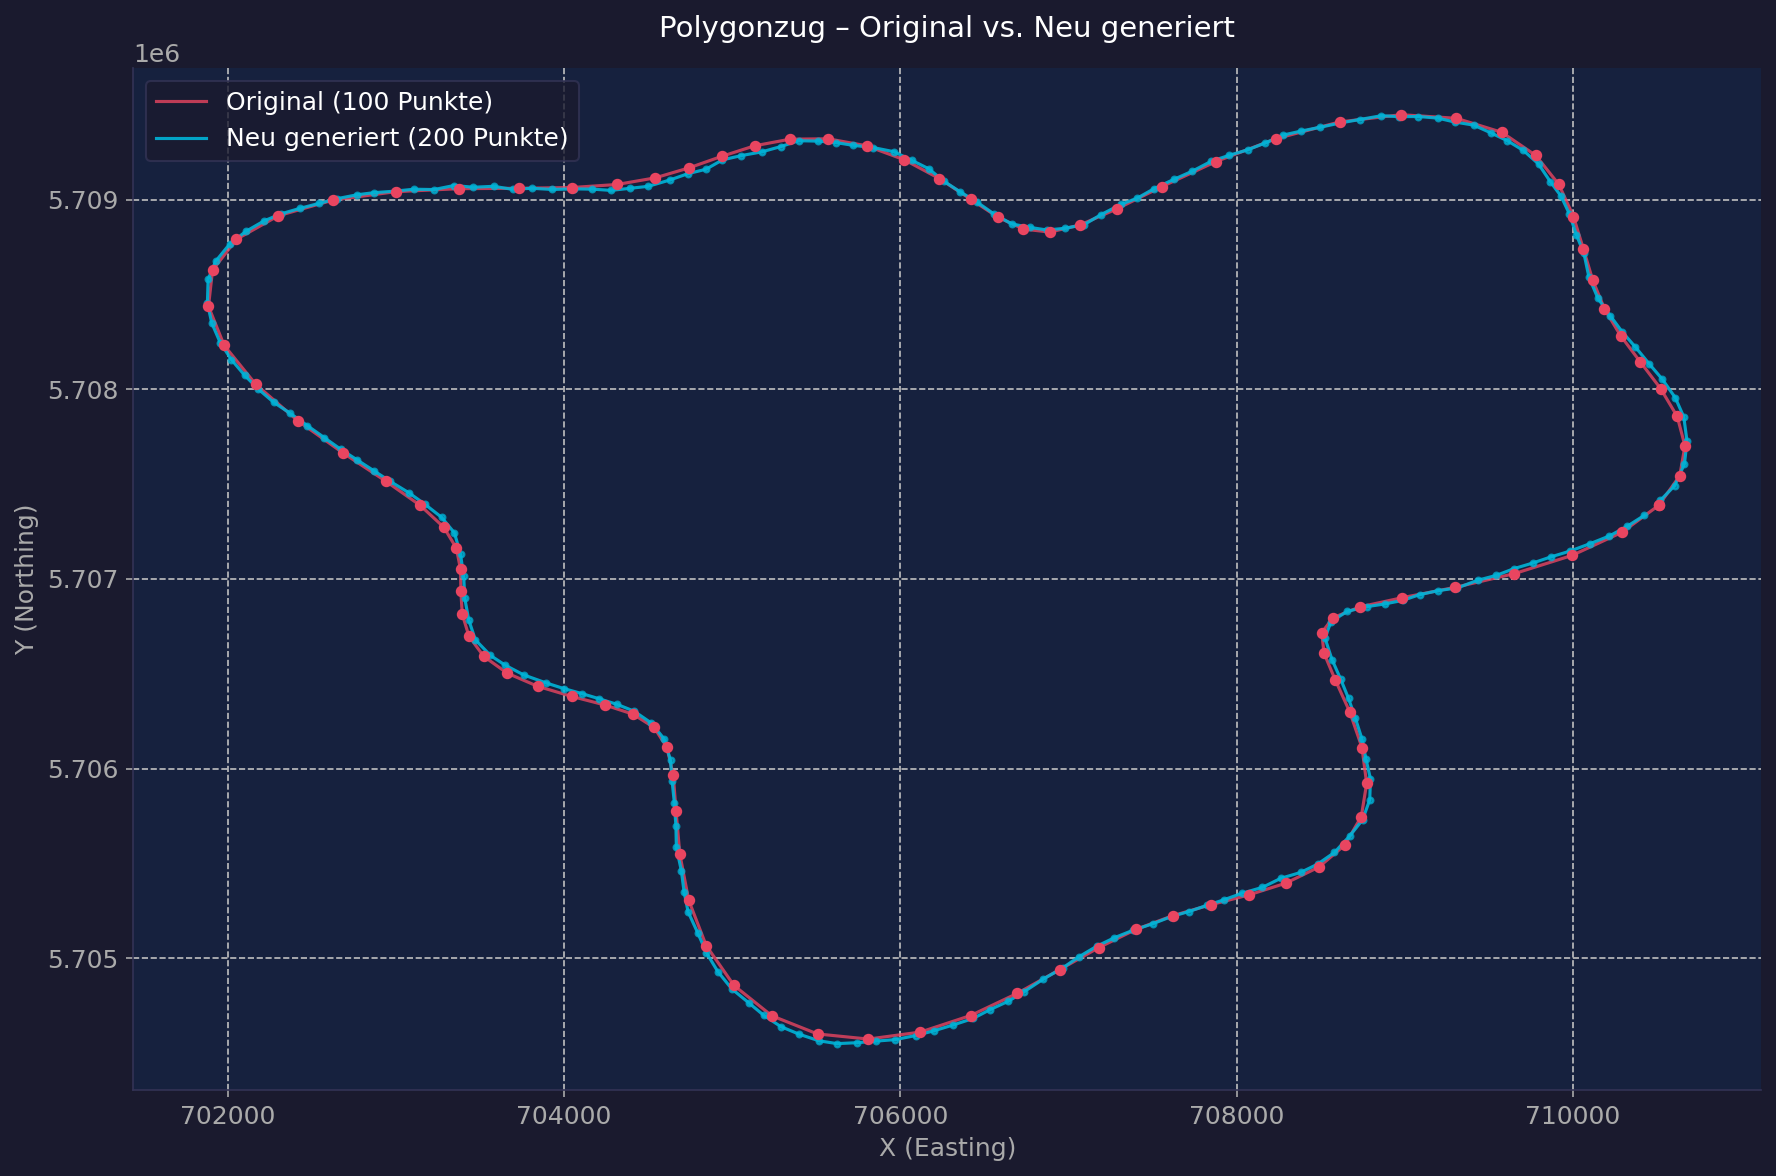
Das neue QGIS-Plugin „Coord2Polygon“ [1] dient der Generierung von Geometrien aus Koordinaten. Dabei stehen zwei Methoden zur Verfügung. Zum einen die Angabe von Fenster-Koordinaten (xmin, ymin, xmax, ymax) und zum anderen die Eingabe eines Polygonzuges aus vielen Korrdinatenpaaren per Semikolon getrennt. In beiden Fällen wird bei der Generierung der Polygon-Geometrie ein neuer temporärer Layer „Coord2Polygon“ erstellt. Sollte es diesen schon geben, werden die Ergebnisse der Generierung in diesem Layer gespeichert. Bei Polygonzügen mit Geometriefehlern (z. B. Selbstüberschneidungen) wird gewarnt, sie können auf Wunsch trotzdem importiert werden. Die Koordinaten müssen im aktuellen Koordinatensystem Eures QGIS-Projekts vorliegen. Details findet Ihr auf der Webseite [2], Code [3] und Lizenz [4] auf GitHub. Einige Testdaten stehen zum Download bereit. Bitte beachtet auch die Nutzungsbedingungen [6].
Damit reiht sich ein weiteres Plugin in die Reihe der geoObserverTools [7] ein. Bei der Erstellung des Python-Codes und der Testdaten habe ich mich von einer KI unterstützen lassen. Manch einer wird sich fragen, ob die Funktionen nicht auch mit QGIS-Bordmitteln realisierbar gewesen wäre. Ja, wären sie, aber IMHO mit etlichen Schritten mehr. Für mich ist es so viel einfacher und vor allem schneller. Was meint Ihr?
Screenshot 2: Import erfolgreichScreenshot 3: Auch bei Polygonzügen mit Geometriefehlern (z. B. Selbstüberschneidungen) kann nach Warnung und Bestätigung importiert werden.
Testdaten: Es stehen drei Testdateien für Polygonzüge, zwei mit 100, eine mit 200 Stützstellen zum Download [5] im EPSG:25832 bereit. In einer Datei sind beabsichtigt Geometriefehler enthalten.
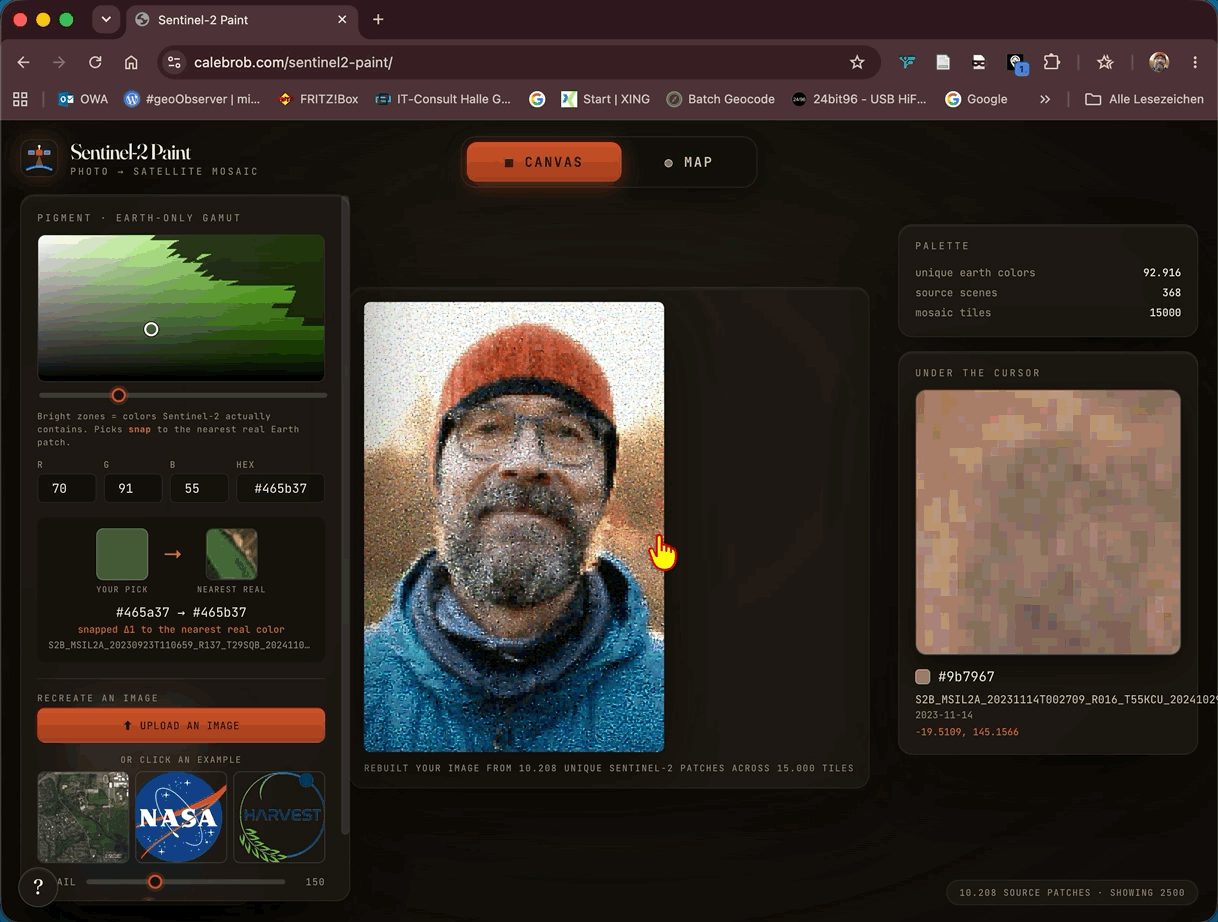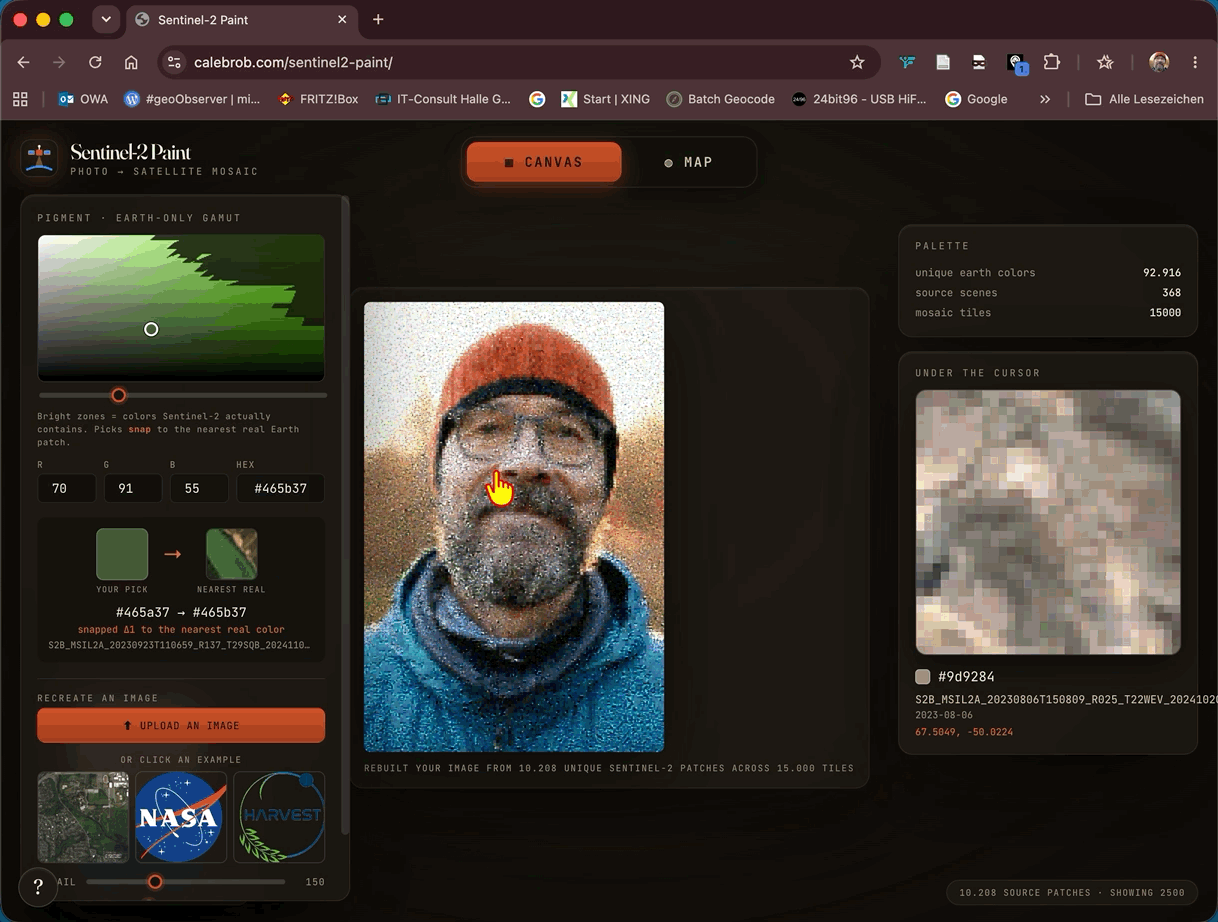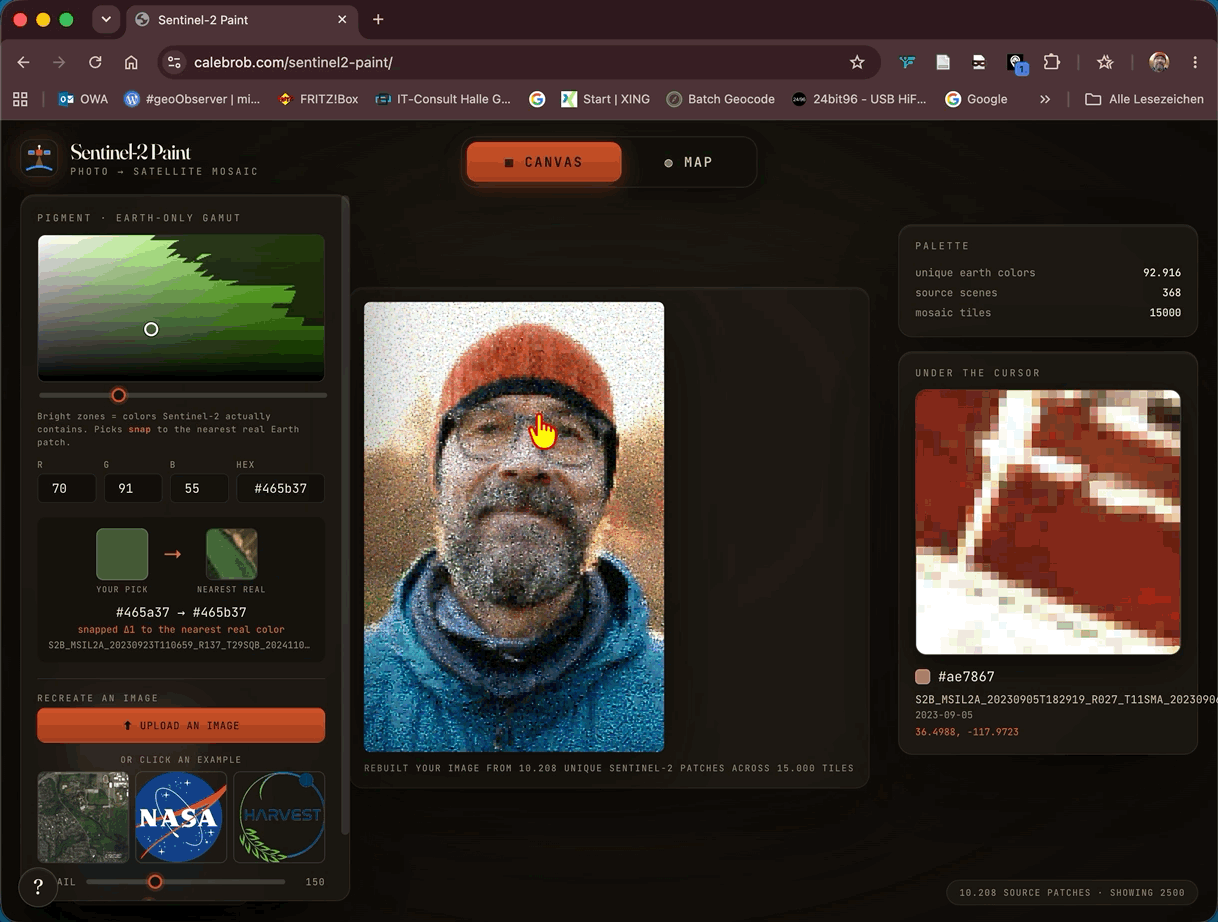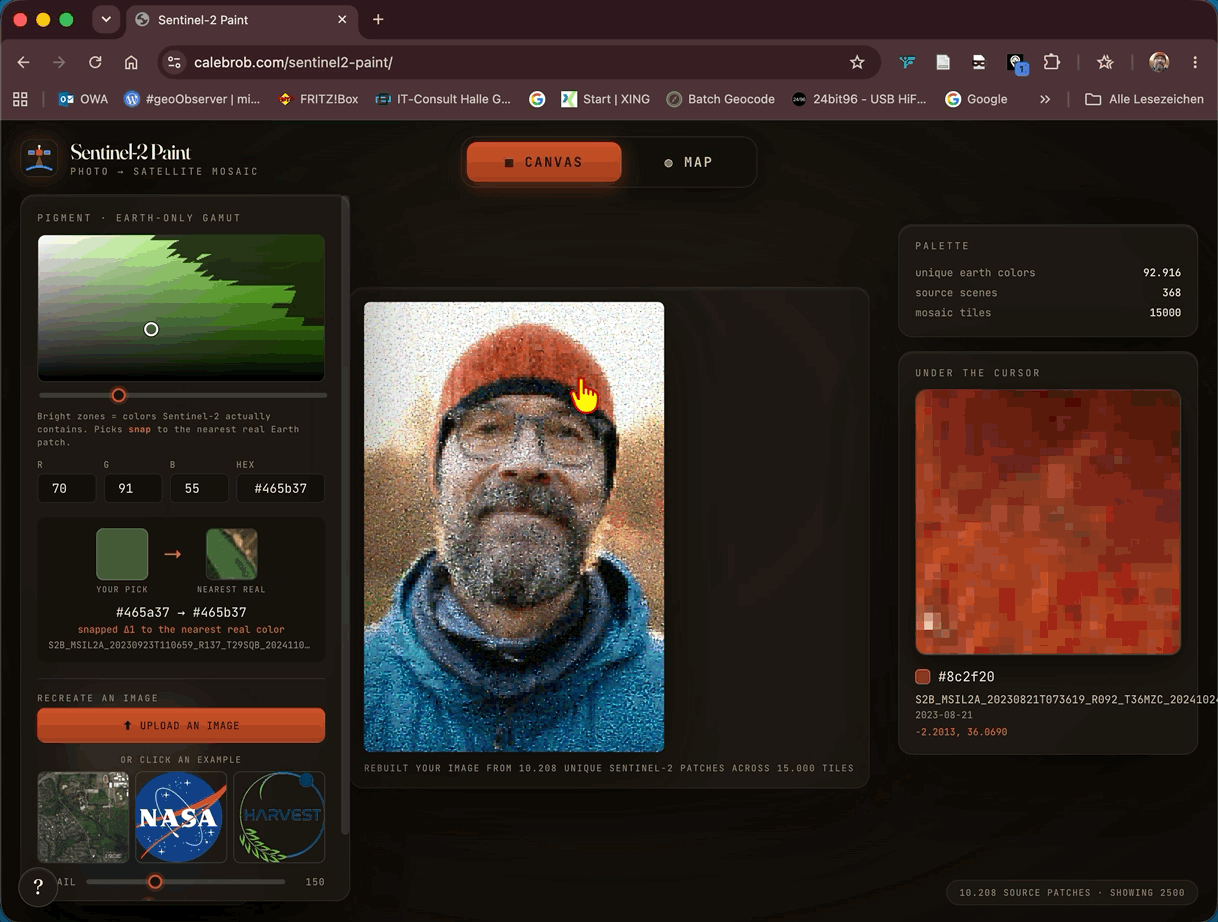
Screenshot: Selbstversuch – Der #geoObserver als Satellitenbildermosaik
Im April hatte ich hier in „Cool: Dein Name aus Satellitenbildern“ [1] darüber berichtet, wie man aus realen Satellitenbildern Schriftzüge erstellen kann. Nun habe ich in der Wochennotiz 834 [2] einen Beitrag mit einer Anwendung gefunden, die auch reale Satellitenbildern, diesmal von „Sentinel 2“ verwendet. Hier werden die Satellitenbilder genutzt, um hochgeladene Bilder in einer Browser-App als Mosaik einzufärben. Navigiert Ihr durch das Ergebnis, zeigt die App auf jedem Mosaik-Teilchen die reale Szene in der Welt inkl. den Koordinaten. In jedem Fall interessant und unterhaltsam. Ihr findet alle Details unter „Sentinel-2 Paint: Recreate Any Image from Real Satellite Imagery“ [3] und könnt die App unter Sentinel-2 Paint [4] starten. Ich habe es mal im Selbstversuch ausprobiert und es funktioniert perfekt 🙂
Animation: Jedes #geoObserver-Mosaikteilchen ist ein reales Satellitenbild
In letzter Zeit habe ich immer wieder über die KI-gestützte Objekterkennung aus Luftbildern gelesen. Jetzt ist ein neues QGIS-Plugin „AI Segmentation“ [1] von TerraLab im QGIS Plugin Repository [2] erschienen und ich habe es am Wochenende mal getestet. Ich habe vorher noch nie selbst eine KI zur Objekterkennung aus Luftbildern verwendet, es war sozusagen mein erstes Mal 😉
Installation und Anmeldung waren unkompliziert und funktionierten tadellos. Wie beschrieben können Rasterdaten aller Art genutzt werden, ich habe mich für die DOP 20 auf dem Open Data Portal Sachsen-Anhalt entschieden, natürlich mit den GeoBasis_Loader [3] ins QGIS geladen. Dann noch schnell ein Rechteck für den interessierenden Bereich markiert und die Erkennung gestartet, in meinem Fall für Gebäude und Bäume. Die Ergebnisse werden in einem GeoPackage gespreichert und sind so schnell weiter ver- und bearbeitbar.
Screenshot 1: Mein Test bei den Identifikation von Gebäuden Bäumen im Pauslusviertel in Halle (Saale).
Hier meine Test-Ergebnisse:
Auf den ersten Blick plausible Ergebnisse und erstes Staunen, unscharf Ersterfassung möglich, Verfeinerung wünschenswert
Auf den zweiten und kritischen Blick: einige Unschärfen, z. B. bei Gebäuden (nicht exakte Geometrien und fehlende Erkennung von Innenhöfen) und bei Bäumen (teilweise werden Baumschatten als Bäume interpretiert). Bei der manuellen Segmentierung kann man ja einige Fehler quasi händisch ausschließen
Interssant wäre, wie sich das Modell weiter entwickelt und auf welche Ergebnisse andere Verfahren kommen. Wer Lust hat, hier ist das GeoPackage [4], vielleicht könnt Ihr ja mal mit Euern Modellen testen und uns die Ergebnisse mitteilen. Gerade Niedersachsen [5] scheint man da besonders weit zu sein. Danke!
Heute wieder mal ein Gastbeitrag, diesmal von meinem Fachkollegen Clemens Schenke-Hildebrandt, Geograph, GIS-Consultant und passionierter Rennradfahrer. Danke Clemens!
Wenn eine Karte mehr als eine Karte ist
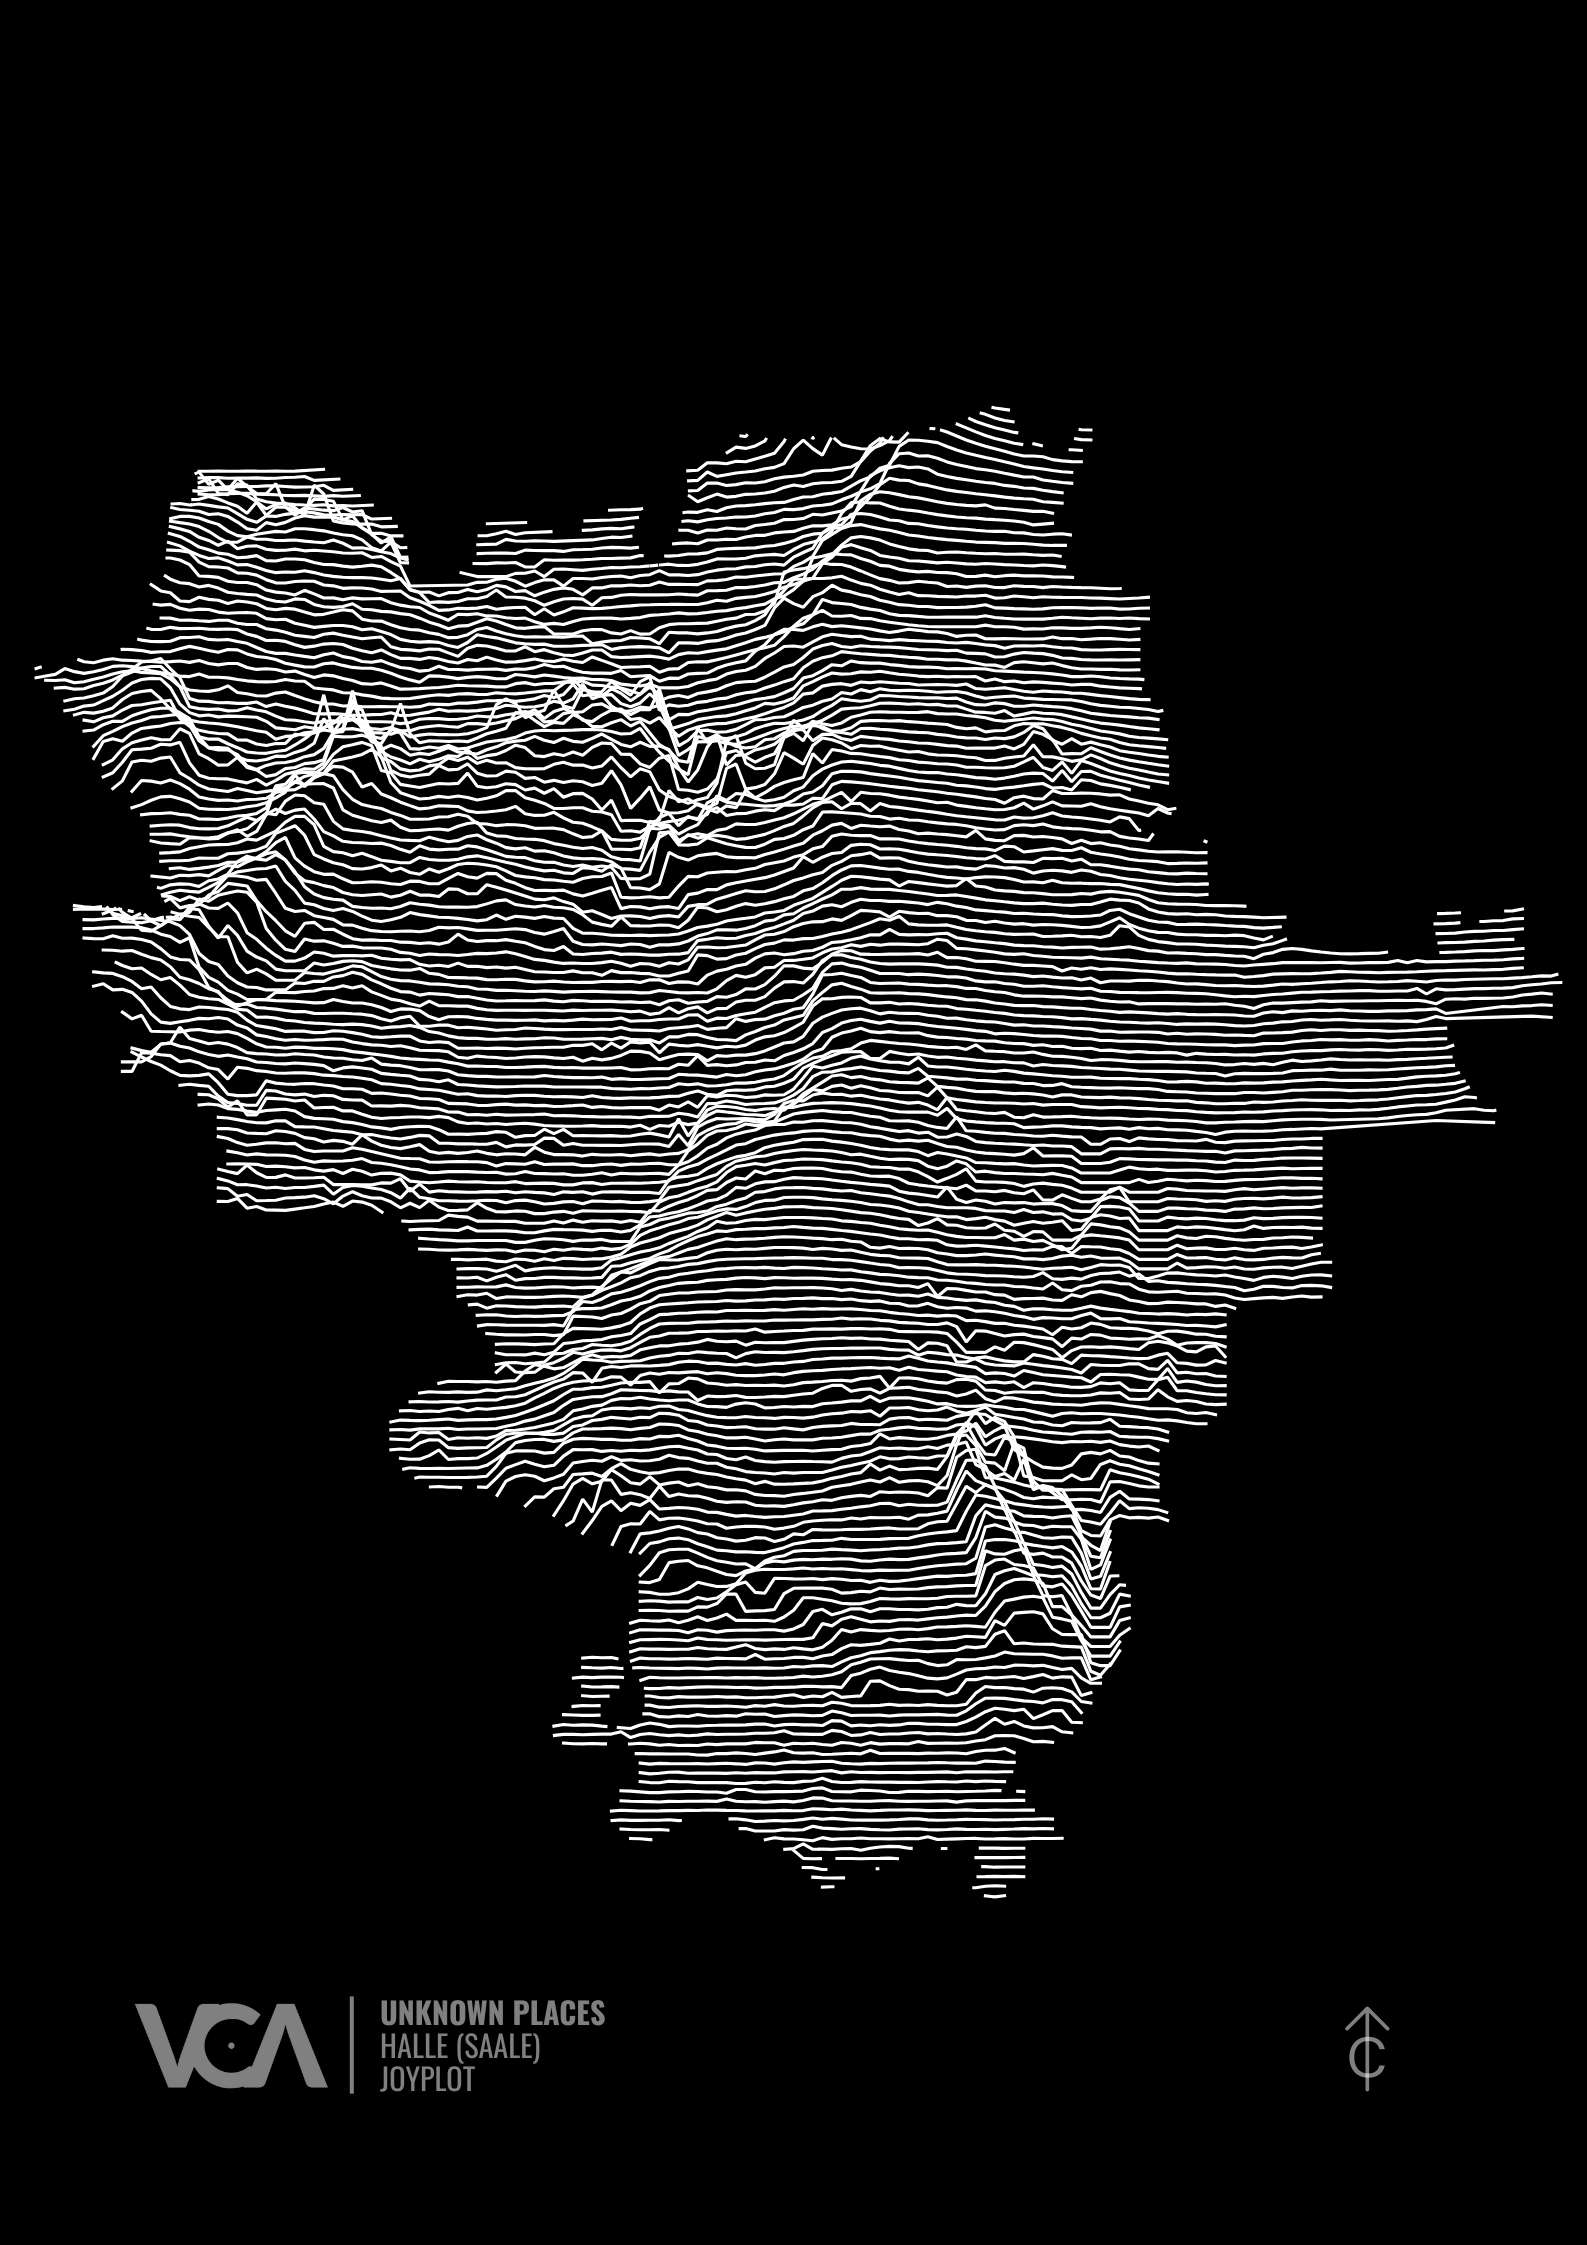
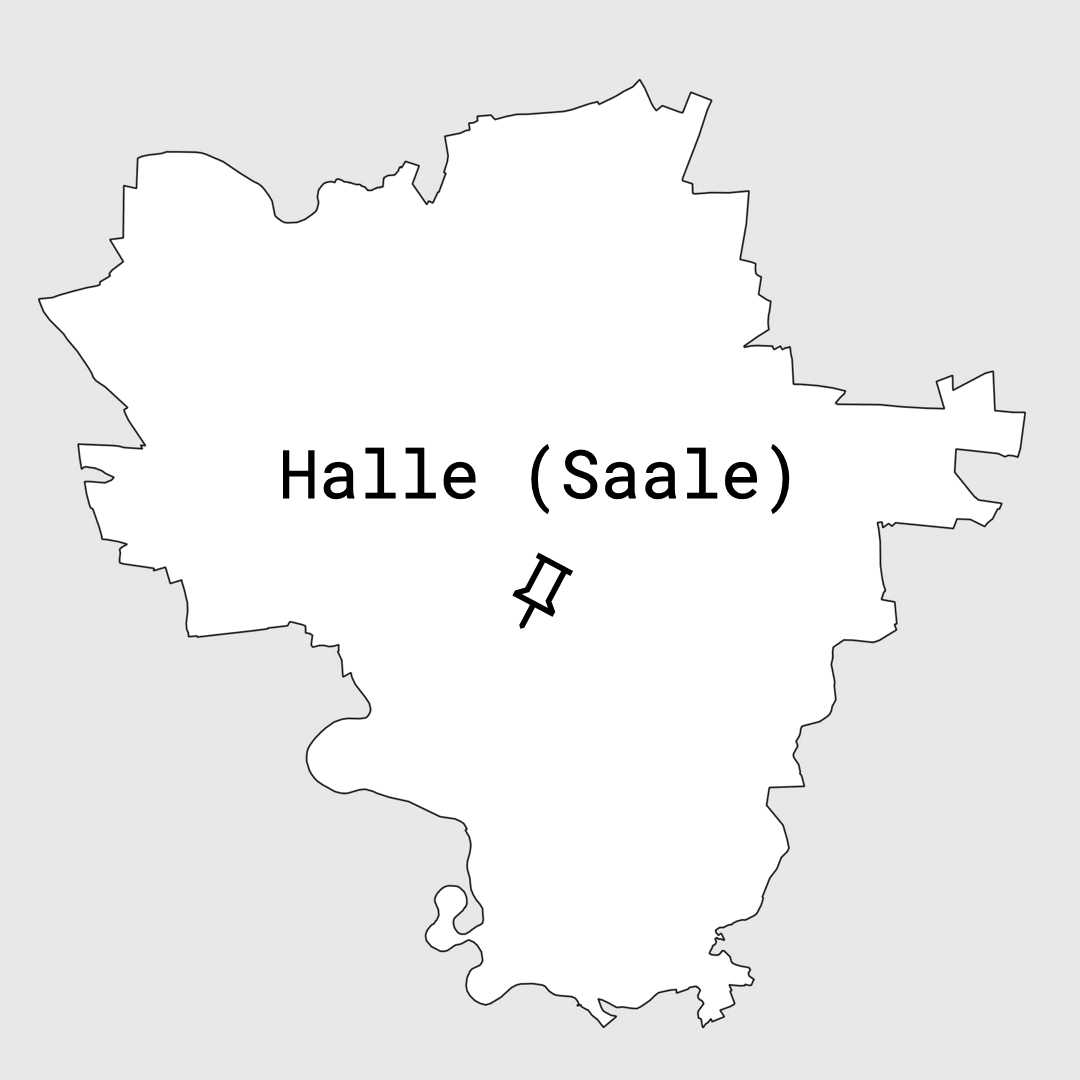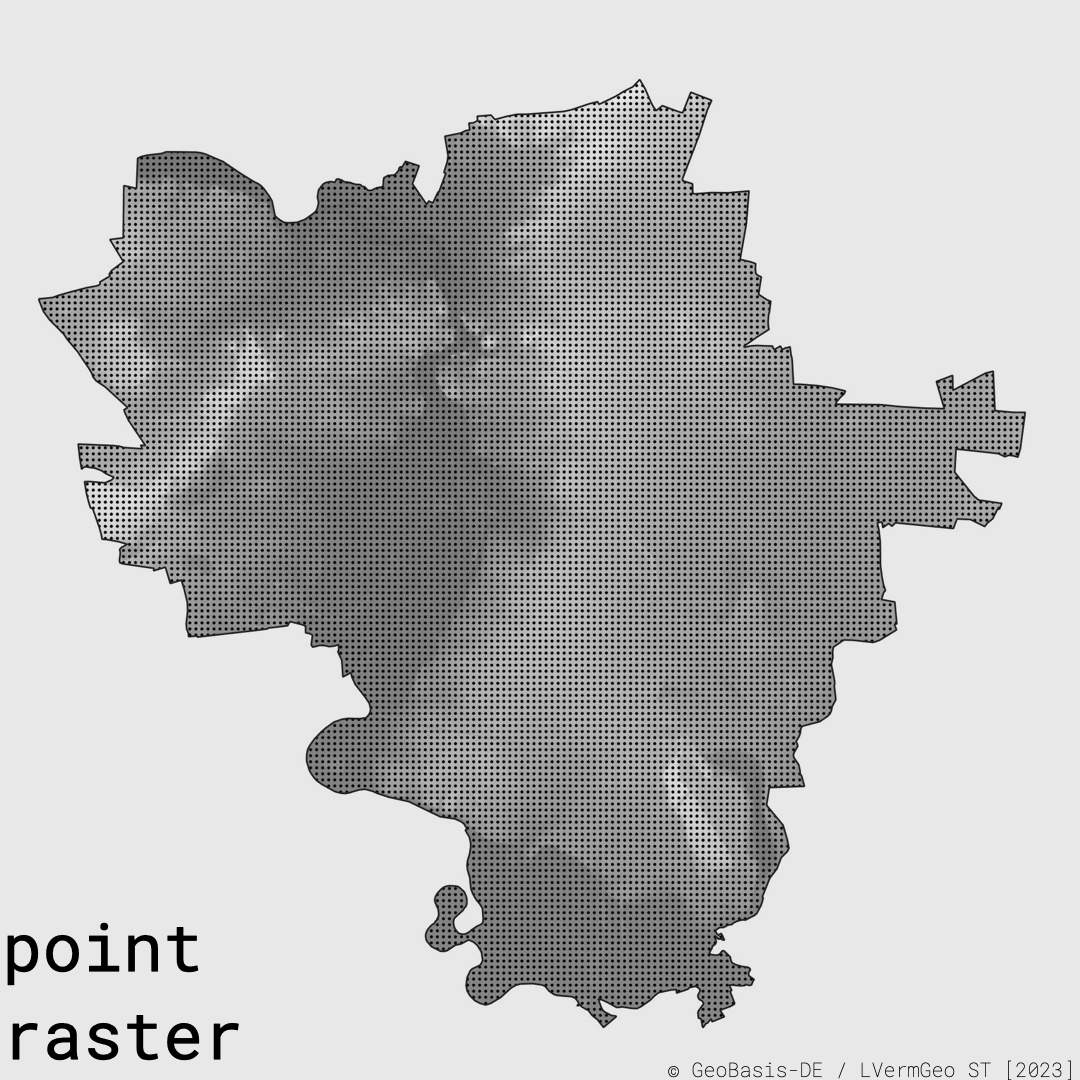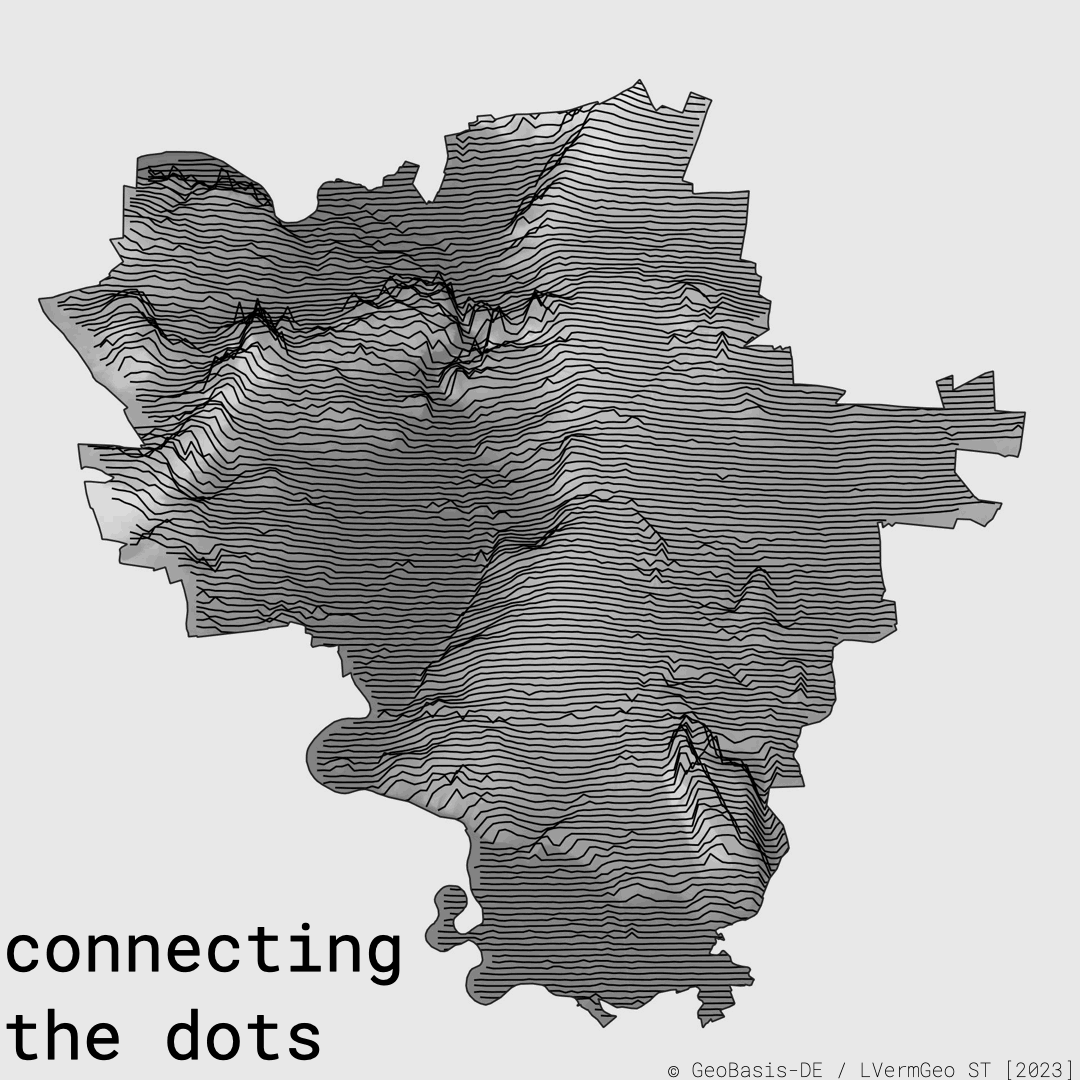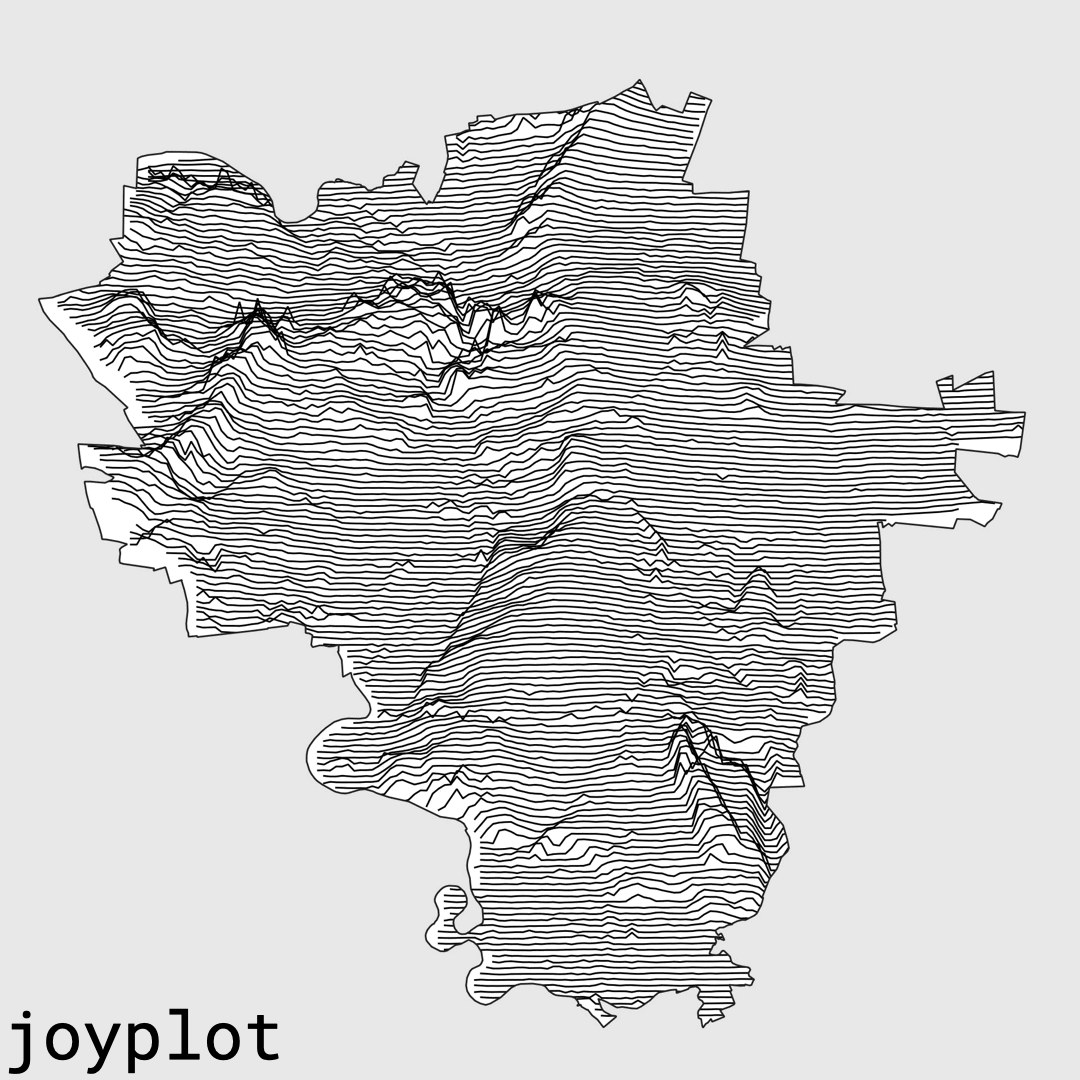
Beim Fahrradverein Veloclub Asphaltrauschen e.V. (VCA) tragen die Vereinsmitglieder ein Trikot, auf dem Linien und Höhen zu erkennen sind, die eine abstrakte Landschaft auf einer Karte zu bilden scheinen. Dabei handelt es sich aber nicht um einen Stadtplan von Halle (Saale), sondern einen Joyplot der Saalestadt. Wer Halle kennt, erkennt darin nicht sofort jede Straße, aber etwas anderes Markantes: die Saaleaue, die Hochflächen, die Kanten der Stadt – das Gefühl eines Ortes.
Abbildung 1: Joyplot von Halle (Saale) auf schwarzem Hintergrund. Weiße, horizontal versetzte Höhenprofil-Linien bilden die Topografie der Stadt ab
Für mich ist dieses Trikot deshalb ein guter Einstieg in die Geschichte von Geodaten beim VCA.
Die Grafik, der Joyplot, war nicht als klassischer Vereinsaufdruck gedacht. Sie war der Versuch, Halle aus Daten heraus sichtbar zu machen und daraus ein Motiv zu entwickeln, das zum Verein passt und die tiefe Verbundenheit zur Saalestadt widerspiegelt. Die Fahrrad-Community bewegt sich ständig durch die Stadt und das Umland. Warum sollte ihre visuelle Sprache dann nicht aus genau diesem Raum entstehen?
Die ausführlichere Geschichte zum Trikotmotiv steht auf asphaltrauschen.cc: „Unknown Places“ – das Veloclub Asphaltrauschen Trikot. Die Höheninformationen für den Joyplot stammen aus dem Digitalen Geländemodell DGM11 Sachsen-Anhalt.
Angefangen hat diese Verbindung aber einfacher.
Im ersten Corona-Jahr fehlte der lokalen Fahrrad-Community das, was sonst fast selbstverständlich war: gemeinsame Ausfahrten, Training, Treffen, Events und kleine Wettkämpfe. Aus dieser Lücke entstand mit dem Spring Break ein Event mit einer einfachen Idee: Strava-Segmente2 wurden zu kleinen Etappen und jede Woche kam eine neue Herausforderung dazu. Die Ergebnisse wurden manuell zusammengetragen.
Aus heutiger Sicht war das technisch noch ziemlich bodenständig. Keine Datenbank, keine API-Automatisierung, keine große Webanwendung. Ich kopierte Ranglisten aus Strava, pflegte Ergebnisse in Excel und baute eine einfache Übersichtskarte. Aber genau dort begann etwas, das später wichtig wurde: Bewegungsdaten waren nicht nur private Trainingsaufzeichnungen, sie wurden zu Material für ein gemeinsames Spiel.
Der nächste größere Schritt war ein Alleycat.
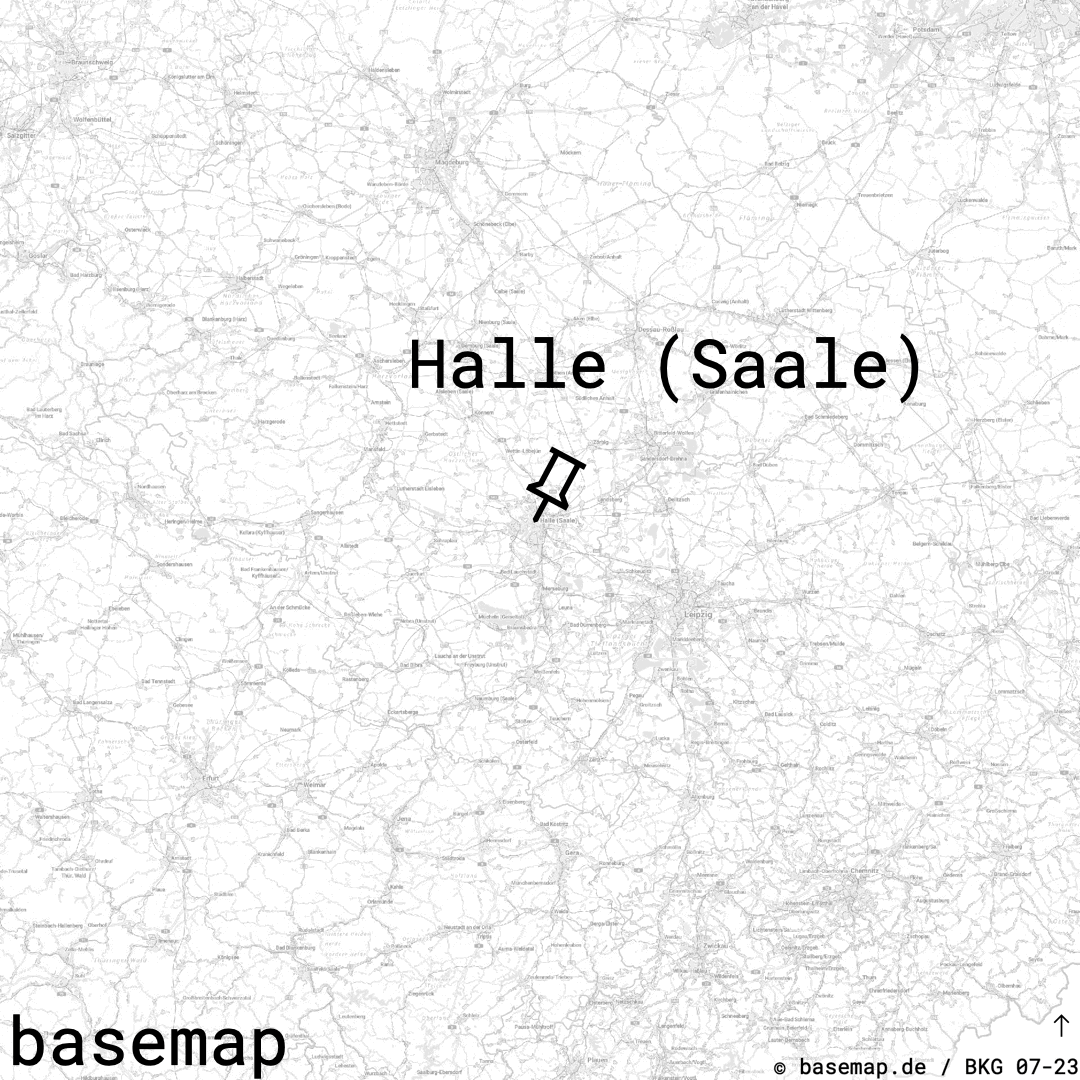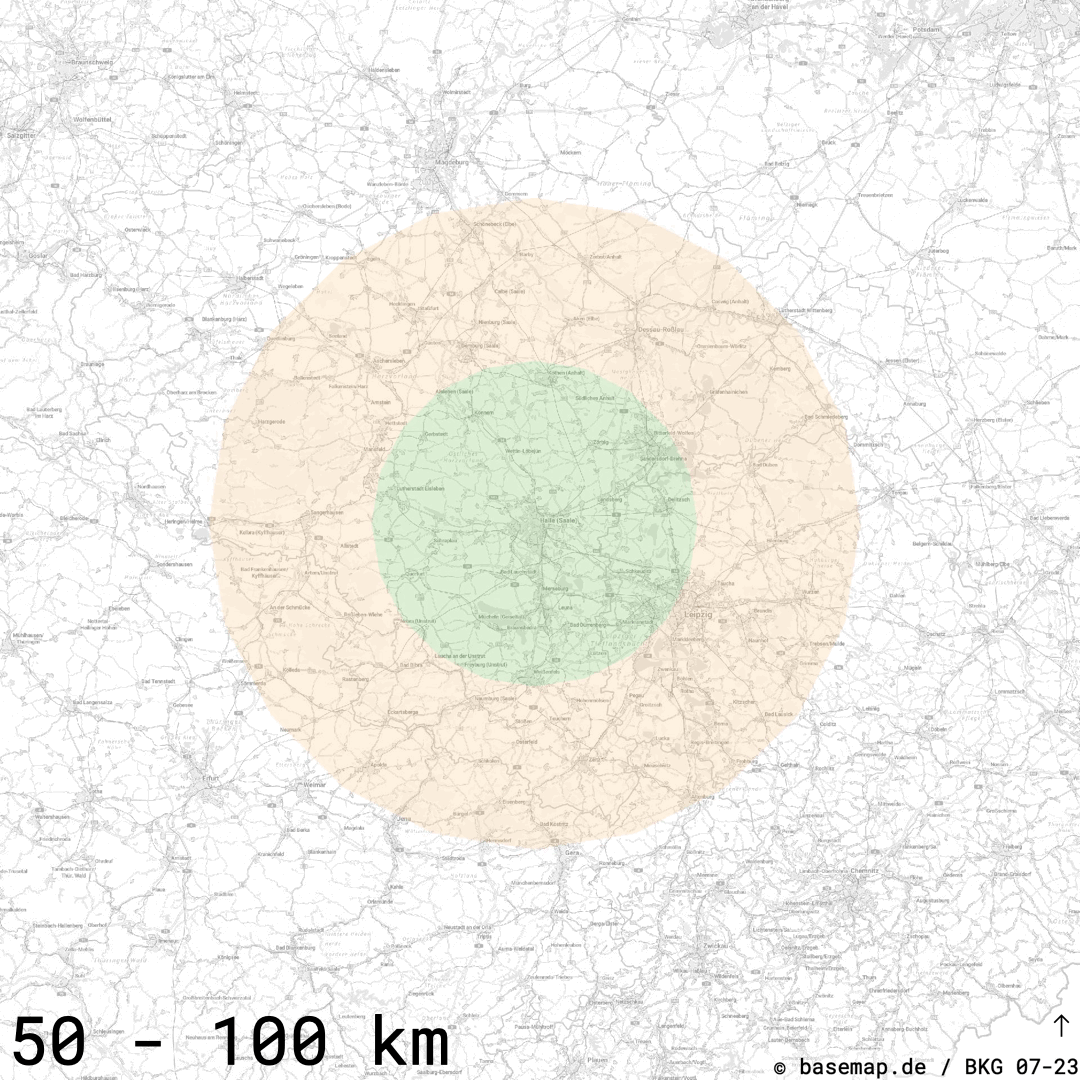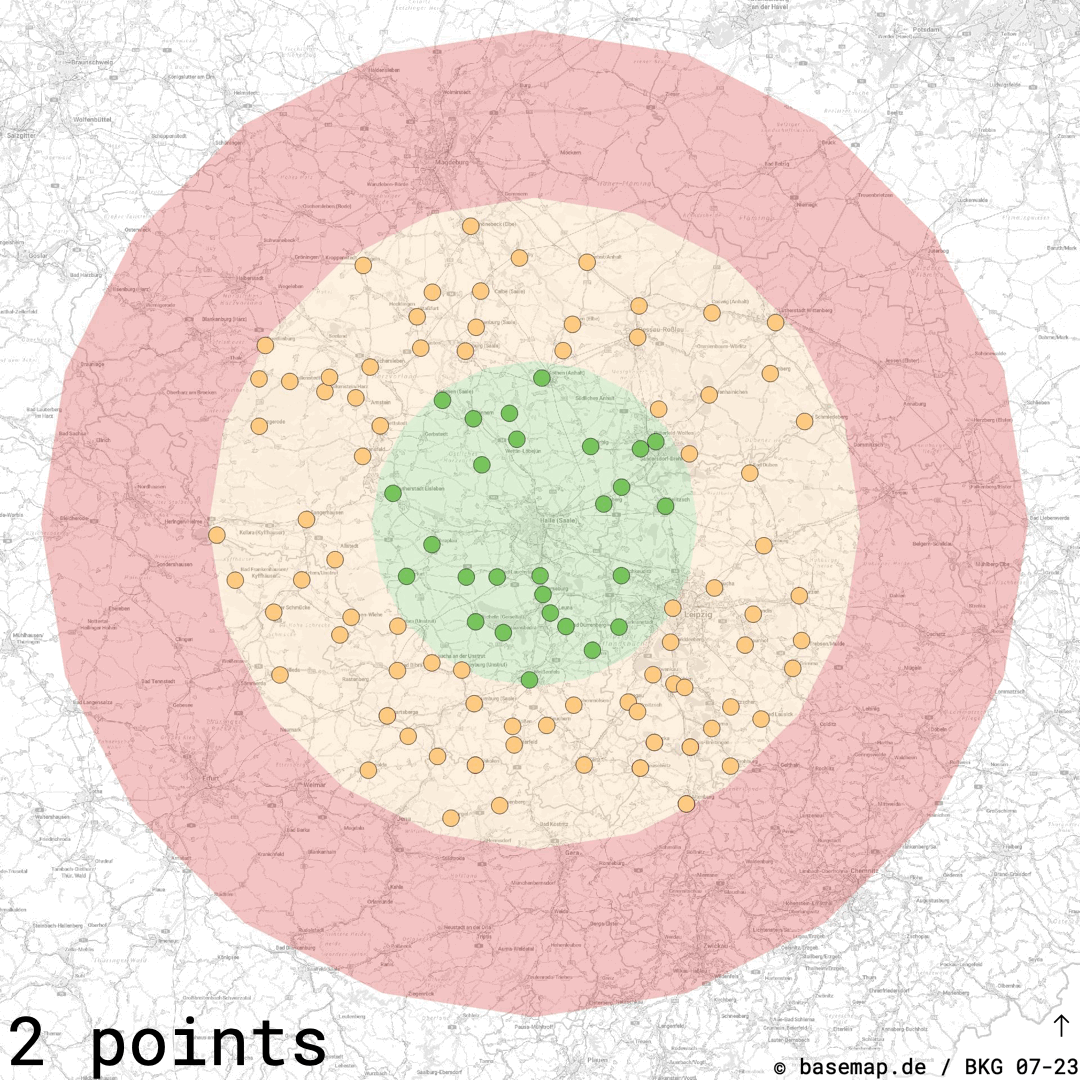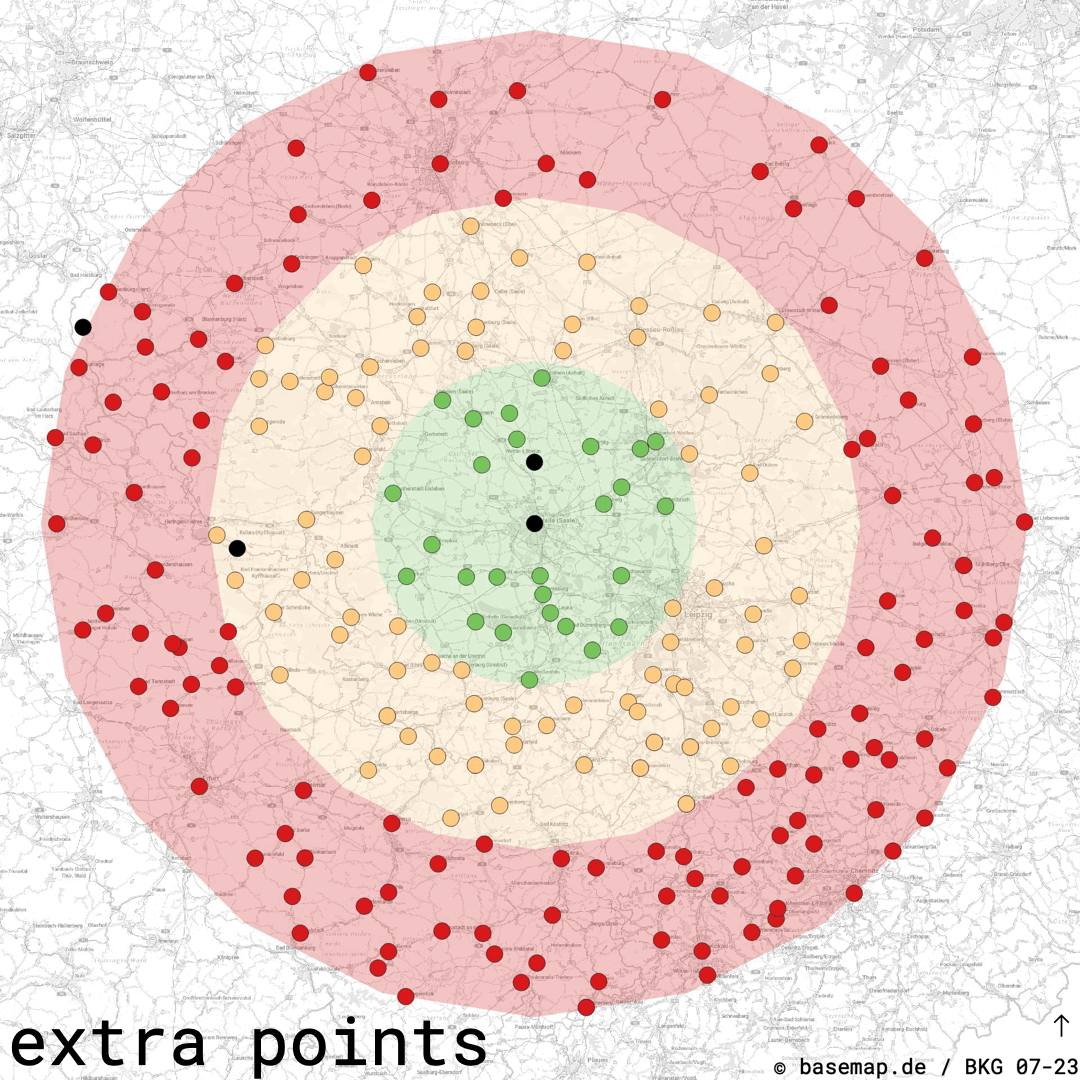
Das klassische Alleycat kommt aus der Fahrradkurierkultur: Checkpoints, Orientierung, Tempo, eigene Routenwahl – vergleichbar mit einer Schnitzeljagd. Für unseren Kontext wurde daraus ein kontaktloses 24-Stunden-Rennen, bei dem Städte, Orte und markante Punkte zu Checkpoints wurden. OpenStreetMap lieferte die Grundlage. Um diese Checkpoints wurden unterschiedliche Radien definiert und wer mit seinem GPX-Track durch diese Bereiche fuhr, sammelte Punkte.
Animation 1: Die Animation zeigt Halle (Saale) auf einer hellen Basemap und entwickelt schrittweise die Checkpoint-Zonen und Checkpoints des Alleycat
Das war für mich der erste Augenblick, in dem GIS beim VCA nicht mehr nur eine begleitende Karte war, sondern wesentlicher Teil der Spielmechanik wurde.
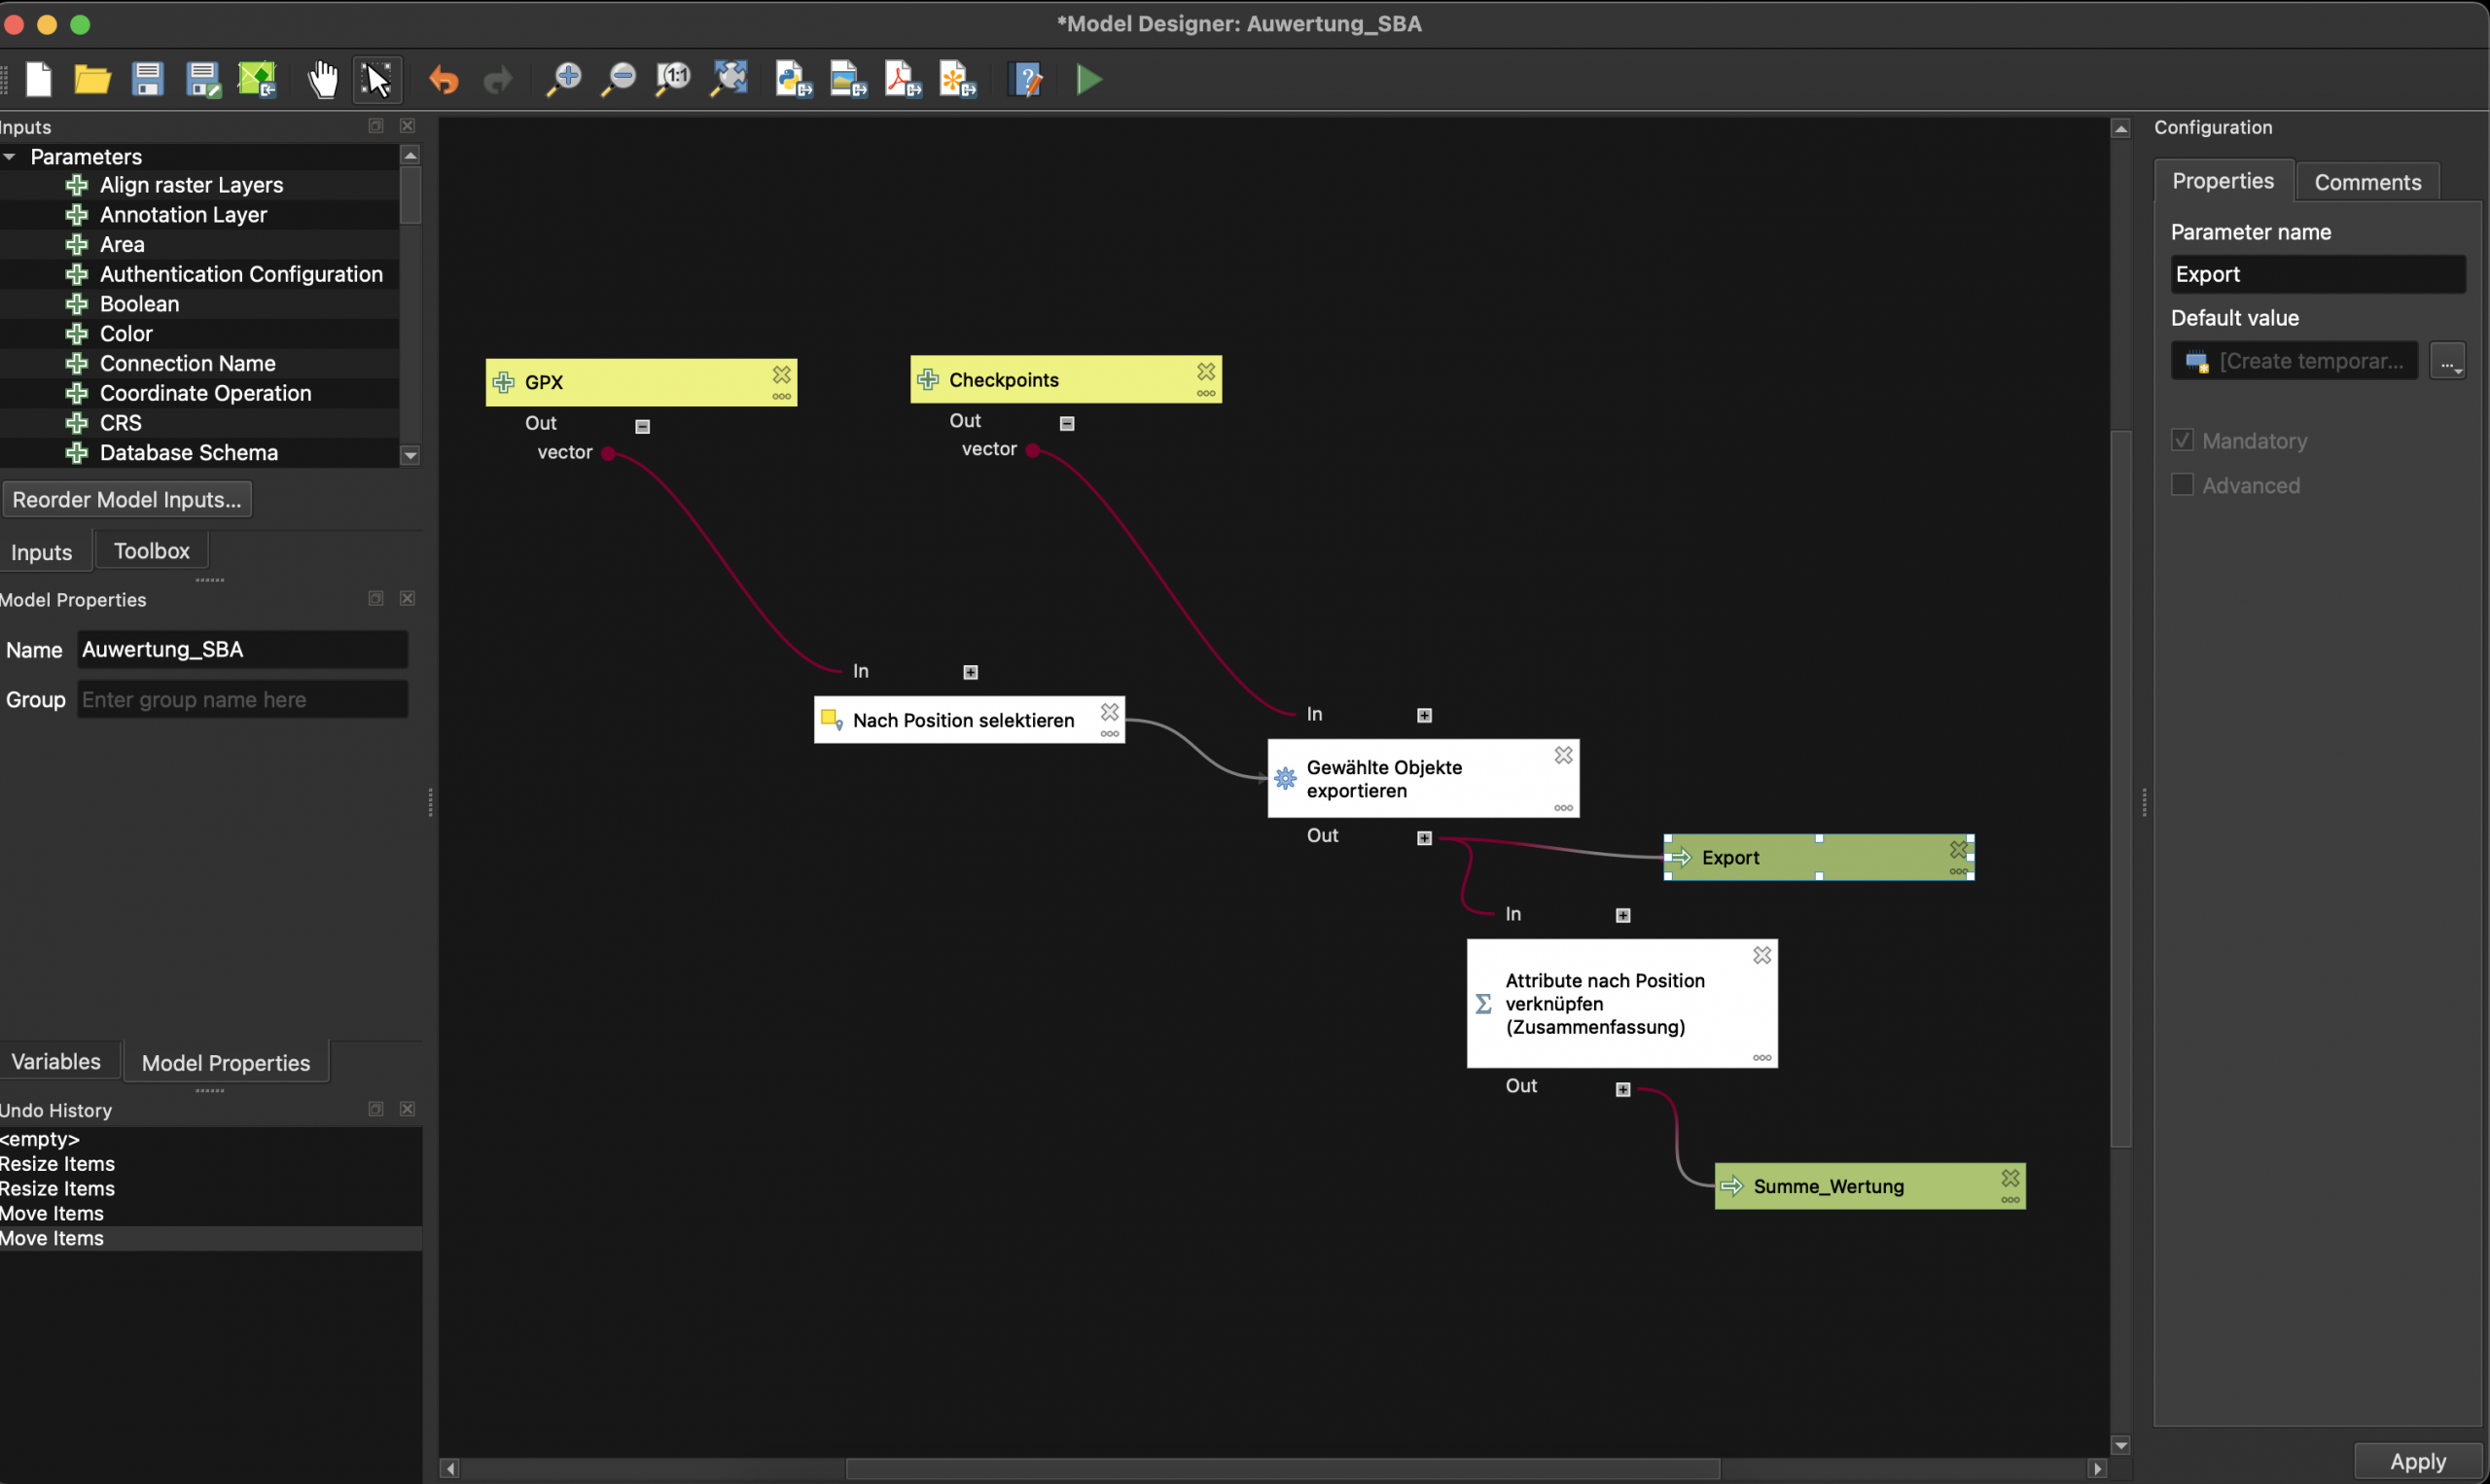
Die Auswertung lief damals noch in QGIS: Checkpoints puffern, GPX-Tracks schneiden, Treffer prüfen, Punkte zusammenrechnen. Ein gutes Bild dafür ist ein Screenshot aus dem QGIS Model Builder: GPX-Dateien und Checkpoints laufen dort als einzelne Verarbeitungsschritte zusammen. Für mich fühlte sich das damals wie Magie an, weil nicht mehr jeder Schritt einzeln nacheinander angeklickt werden musste, sondern der Ablauf als Modell sichtbar und wiederholbar wurde.
Abbildung 2: QGIS Model Builder im dunklen Theme mit dem Modell „Auswertung_SBA“. Zu sehen sind die Eingaben „GPX“ und „Checkpoints“ sowie Verarbeitungsschritte wie „Nach Position selektieren“, „Gewählte Objekte exportieren“ und „Attribute nach Position verknüpfen (Zusammenfassung)“. Das Modell zeigt, wie GPX-Tracks und Checkpoints zu exportierten Treffern und einer Summenwertung verarbeitet werden
Nichts davon war als großes Produkt gebaut. Aber es zeigte, wie stark sich Radfahren, offene Geodaten und einfache räumliche Regeln verbinden lassen. Der Joyplot von Halle kam später aus einer anderen Richtung. Nicht mehr: Wer fährt wo entlang? Sondern: Wie kann eine Stadt als Datenbild aussehen?
Ein Joyplot besteht aus vielen versetzten Profilen und für Halle bedeutete das: Höhendaten abtasten, Linien erzeugen, die Topografie abstrahieren. So wurden die Saaleaue, die nördlichen Felskanten, die Dölauer Heide und die Hochflächen der Stadt nicht als exakte Karte gezeigt, sondern als Rhythmus.
Animation 2: Entstehungsprozess des Joyplots von Halle (Saale). Die Animation beginnt mit der Stadtgrenze und einer Markierung in Halle und entwickelt schrittweise die abstrahierten Höhenlinien, aus denen der Joyplot entsteht.
Als daraus die Idee für ein Trikotmotiv entstand, veränderte sich die Rolle der Geodaten noch einmal: Sie waren nicht mehr nur Werkzeug für Auswertung oder Orientierung, sie wurden Teil einer Vereinsidentität.
Diese Entwicklung finde ich bis heute spannend. Geodaten wirken durch Koordinaten, Layer, Projektionen, Attribute und Formate oft technisch. Im Alltag eines Fahrradvereins zählt aber etwas Anderes: In der Nutzung muss eine Karte nicht nur korrekt, sie muss anschlussfähig sein. Sie muss einen Anlass tragen können, eine Ausfahrt erklären, eine Erinnerung festhalten oder ein Gefühl für einen Ort transportieren.
Beim VCA ist daraus nach und nach ein kleiner Werkzeugkasten entstanden. Mal geht es um Strava-Segmente und Rankings, dann um Checkpoints und GPX-Tracks oder um Höhendaten, OSM-Daten oder reduzierte Routengrafiken. Später kamen Python, eigene Skripte und automatisierte Workflows dazu. Aber der Ausgangspunkt war nicht Technik um der Technik willen. Der Ausgangspunkt war immer eine konkrete Frage aus der Community:
Wie halten wir Verbindung, wenn wir nicht gemeinsam fahren können?
Wie machen wir aus einer Route ein Spiel?
Wie macht man eine Stadt zur Vereinsidentität, zu einem Trikotmotiv?
Wie zeigen wir, was unsere Ausfahrten unterscheidet?
Genau an dieser Stelle treffen sich für mich Radkultur und GIS.
Geodaten sind beim Veloclub Asphaltrauschen keine neutrale Hintergrundkarte. Sie sind ein Mittel, um Bewegung, Ort, Gemeinschaft und Gestaltung zusammenzubringen.
Aus diesem Werkzeugkasten sind später vier sehr unterschiedliche Kartenlinien entstanden: Social Ride, FLINTA*-Ride, Schotterbande und Temporunde. Jede dieser Runden hat ihren eigenen Charakter, und jede Karte versucht, diesen Charakter sichtbar zu machen. Aber das ist eigentlich schon die nächste Geschichte.
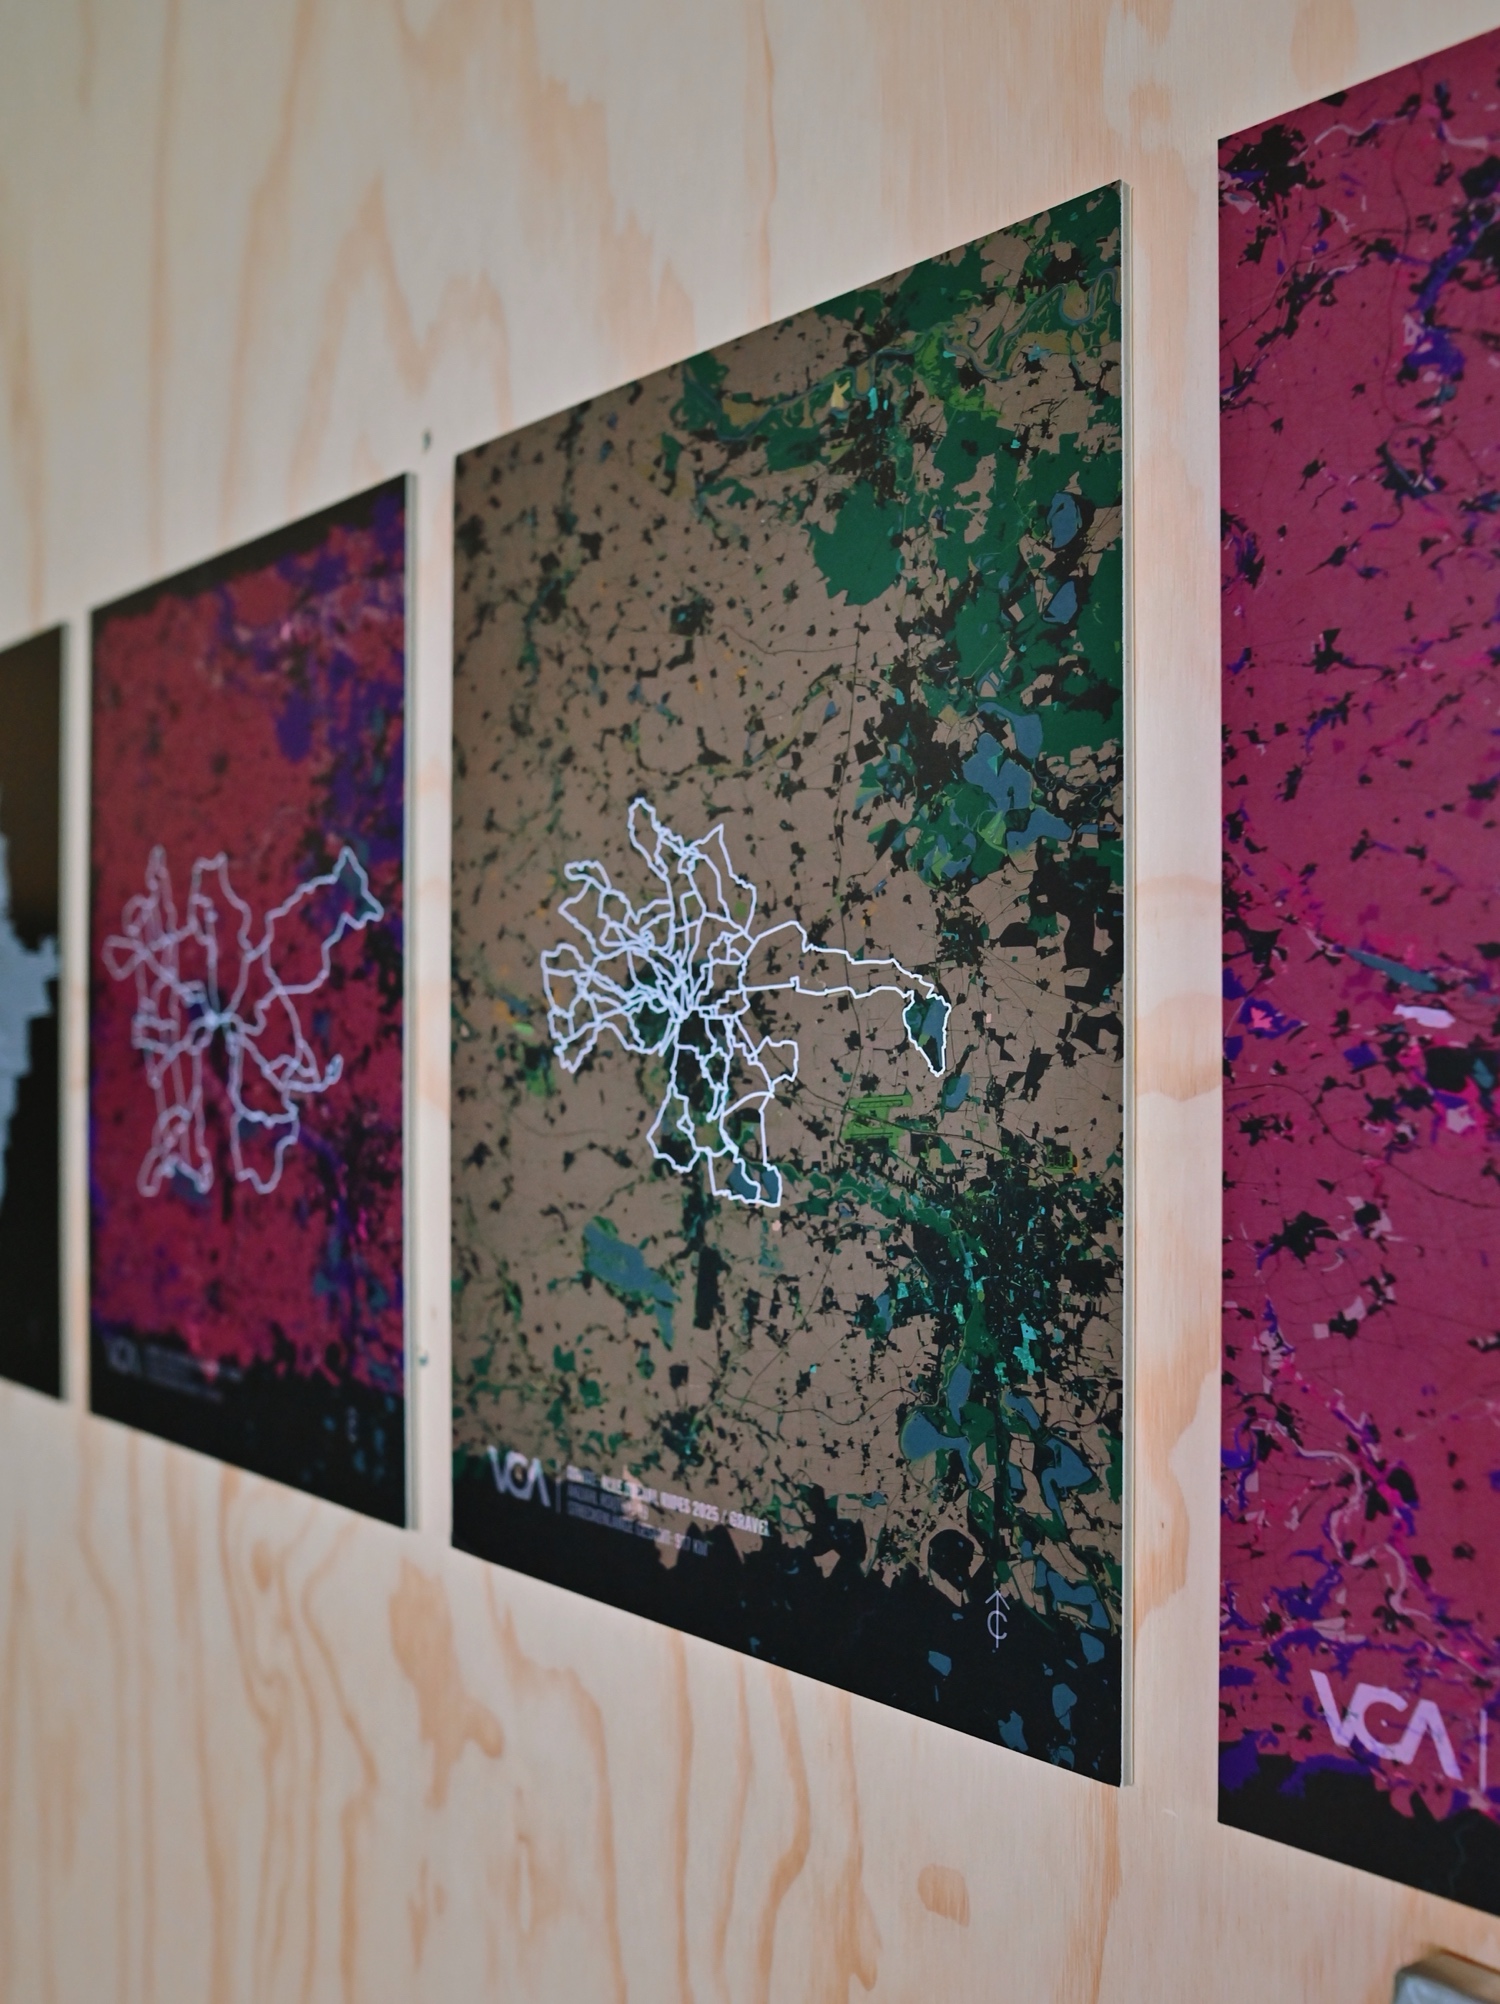
Abbildung 3: Foto vom VCA-Flohmarkt: Mehrere großformatige VCA-Grafiken hängen an einer hellen Holzwand. Im Mittelpunkt ist eine grün-beige Kartengrafik mit weißen Routenlinien zu sehen; links und rechts hängen weitere farbige Kartenmotive. Foto: Friederike Schöppe
Zum Autor: Clemens Schenke-Hildebrandt ist Geograph, GIS-Consultant und Product Owner mit Schwerpunkt auf Geodaten, WebGIS, Kartenanwendungen und produktnaher Softwareentwicklung. Beim VCA verbindet er Radkultur, Community-Projekte und Geodatenarbeit, unter anderem in Karten, Visualisierungen und GPS-basierten Challenges. Kontakt: https://linktr.ee/clemensschenke
DGM1 steht für Digitales Geländemodell mit einer Rasterweite von 1 m. Für Sachsen-Anhalt stellt das Landesamt für Vermessung und Geoinformation Sachsen-Anhalt das DGM1 kostenfrei bereit: https://www.lvermgeo.sachsen-anhalt.de/de/gdp-dgm1.html. ↩︎
Ein Strava-Segment ist ein festgelegter Abschnitt auf einer Straße, einem Weg oder einer Strecke, für den Strava automatisch Zeiten aus aufgezeichneten Aktivitäten vergleicht. Wer eine Fahrt oder einen Lauf hochlädt und durch dieses Segment kommt, erscheint mit der eigenen Zeit in einer Rangliste. Für den Spring Break konnten solche Segmente deshalb wie digitale Etappen genutzt werden: Die Strecke war klar definiert, die Zeitmessung kam aus den GPS-Aufzeichnungen, und die Ergebnisse mussten anschließend nur noch ausgewertet werden. ↩︎
Über die Berechnung des NDVI (Normalized Difference Vegetation Index) habe ich erst neulich in „NDVI: Realisierung mit QGIS, Standard & Grenzen“ [1] geschrieben. Nun hat Ivo Partschefeld alias PyQGIS (@PyQgis) ein neues interessantes Video mit einer wunderbaren Anleitung auf Youtube „Vegetationsindizes aus Orthophoto (DOP) mit QGIS Rasterrechner berechnen“ [2] veröffentlicht. Es zeigt dort z.B. NVDI und SAVI/BBVI, jeder Schritt wird gut erklärt und ist einfach nachzuvollziehen. Einfach mal anschauen, es lohnt sich, Danke Ivo!
Mitunter kann man viel Zeit benötigen, um Daten zu prüfen. Eine häufig verwendete Methode ist dabei, die Objekte mit demselben Attributwert zu ermitteln und deren räumlichem Zusammenhang zu berechnen und zu visualisieren. Das kann dann u. U. wieder viel Zeit sparen. Man erstellt dazu s. g. Clusterflächen. Eine wirklich praktikable Lösung dafür liefert das neue QGIS-Plugin „Cluster Generator“ [1]
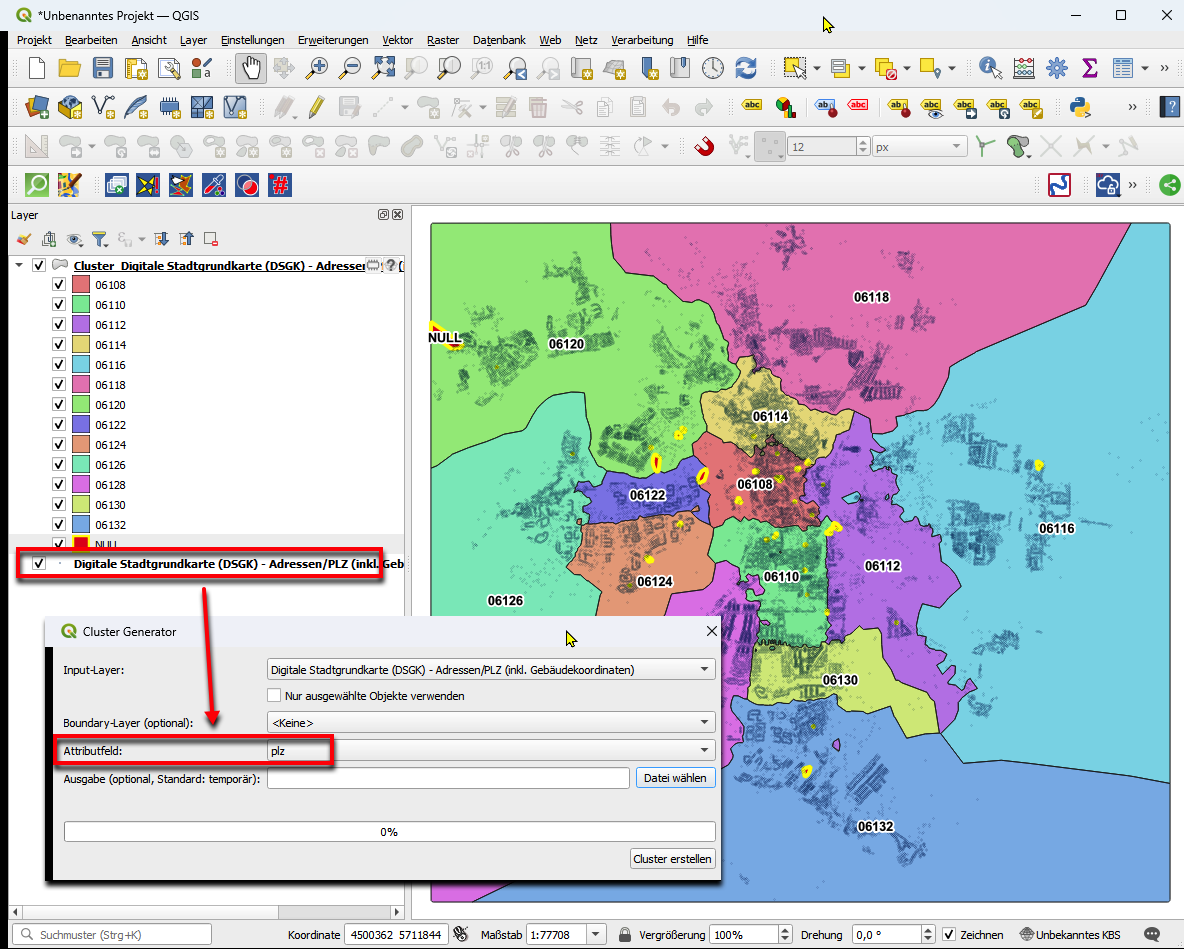
Screenshot 1: Mein Test, 34098 Punkte mit „plz“-Attribut geclustert
Ich habe das Plugin mal kurz angetestet, die Bedienung ist einfach und selbsterklärend. Genutzt habe ich dazu unseren Postleitzahlen- (PLZ-) Datenbestand. Der automatisch einmal pro Nacht generierte Datenbestand hat vfür Halle (Saale) momentan 34098 Punkte mit PLZen. Die Clusterfunktion darauf angewendet liefert recht schnell die Clusterflächen mit den PLZ-Bereichen und färbt und beschriftet diese automatisch nach dem ausgewählten Attributfeld, hier also „plz“. Das Formular und die Ergebnisse findet Ihr in Screenshot 1.
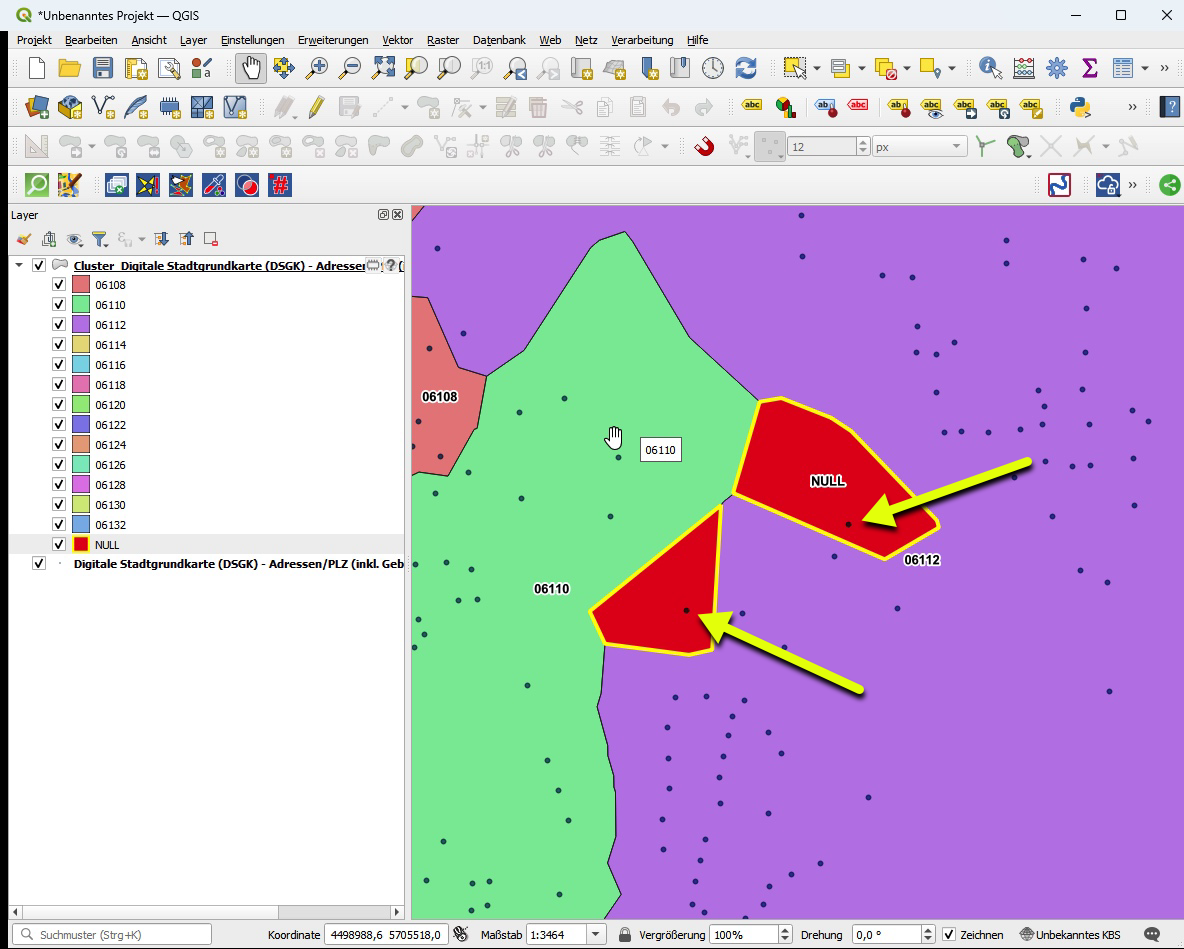
Ein wunderbarer, positiver Nebeneffekt. Man findet so auch ganz schnell, quasi nebenbei die fehlerhaften Objekte, bei meinem Test die Punkte mit dem Eintrag „plz=NULL“. Ich habe diese NULL-Flächen mal etwas hervorgehoben. Für die Punkte in diesen Flächen sind die PLZ-Attributwerte also zeitnah zu aktualisieren, von „NULL“ auf die tatsächliche PLZ oder die Punkte an sich sind zu überprüfen.
Screenshot 2: Fehlerhafte Punkte mit „plz=NULL“ in Extra-Clusterinseln
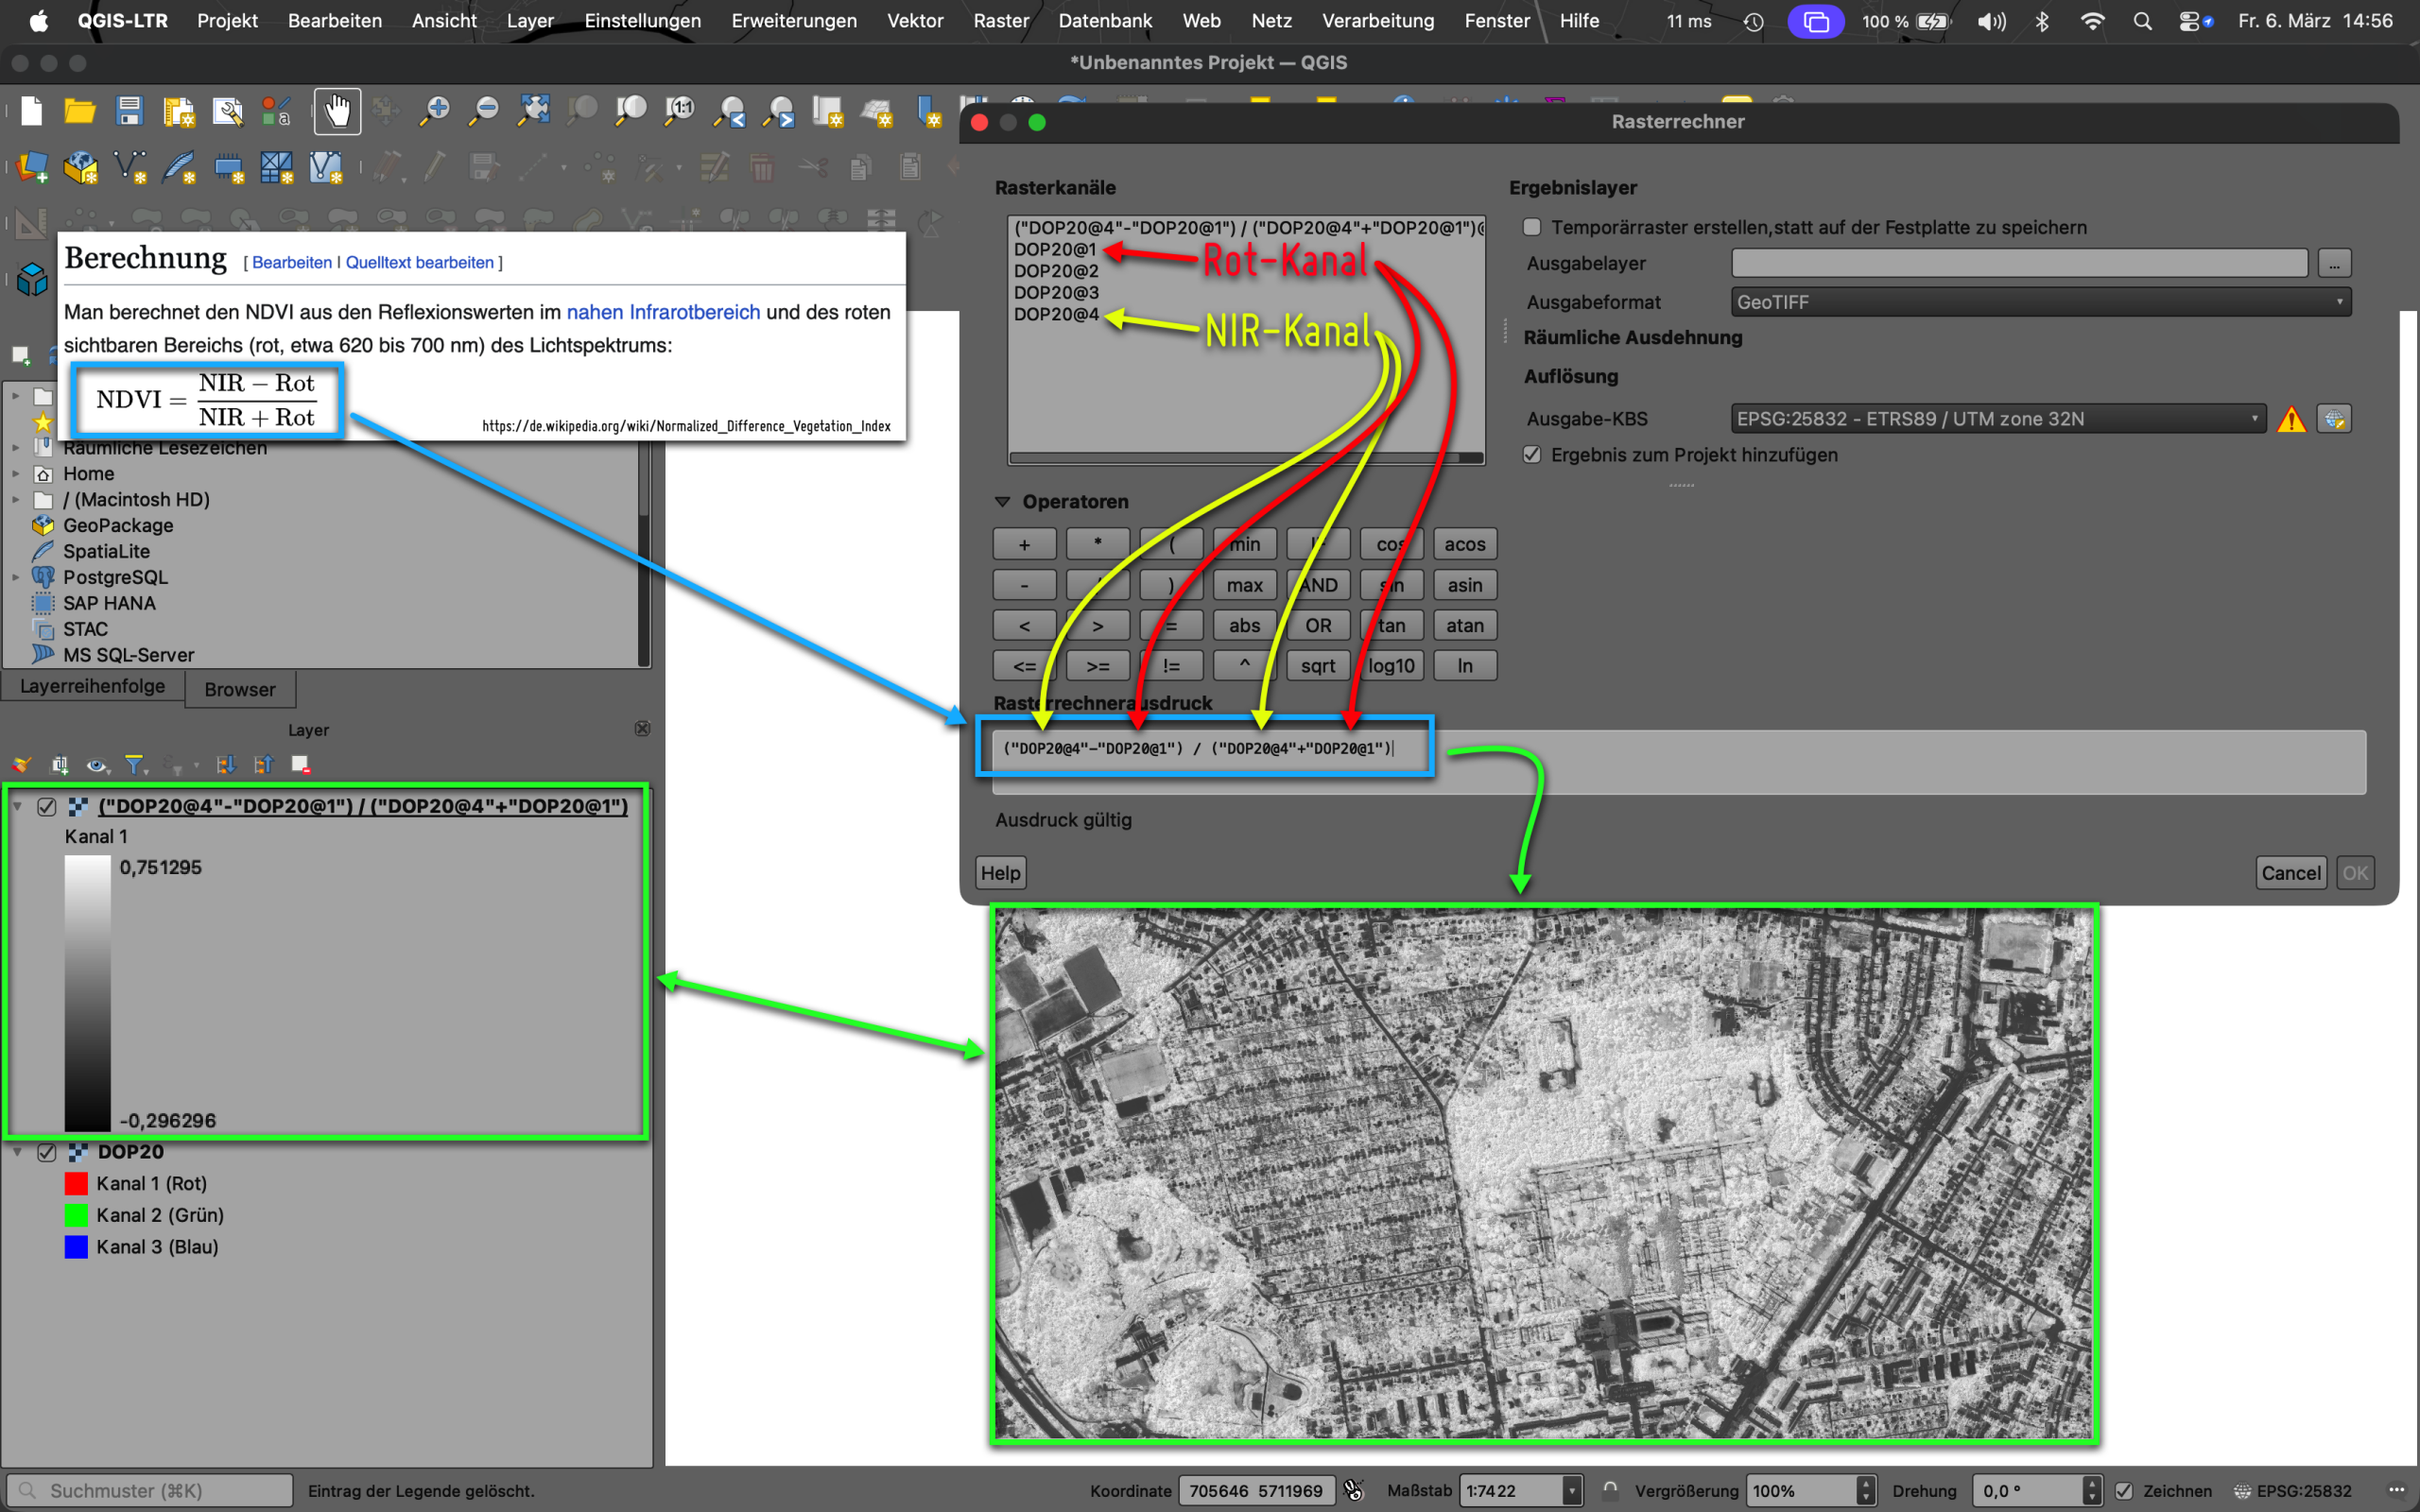
NDVI (Normalized Difference Vegetation Index) [1] ist lt. Wikipedia „der am häufigsten angewandte Vegetationsindex“ und ist seit Jahren ein Standardwerkzeug bei der Beurteilung von Fernerkundungsdaten. In vielen GI-Systemen ist er einfach zu berechnen mit der vergleichbar simplen Formel:
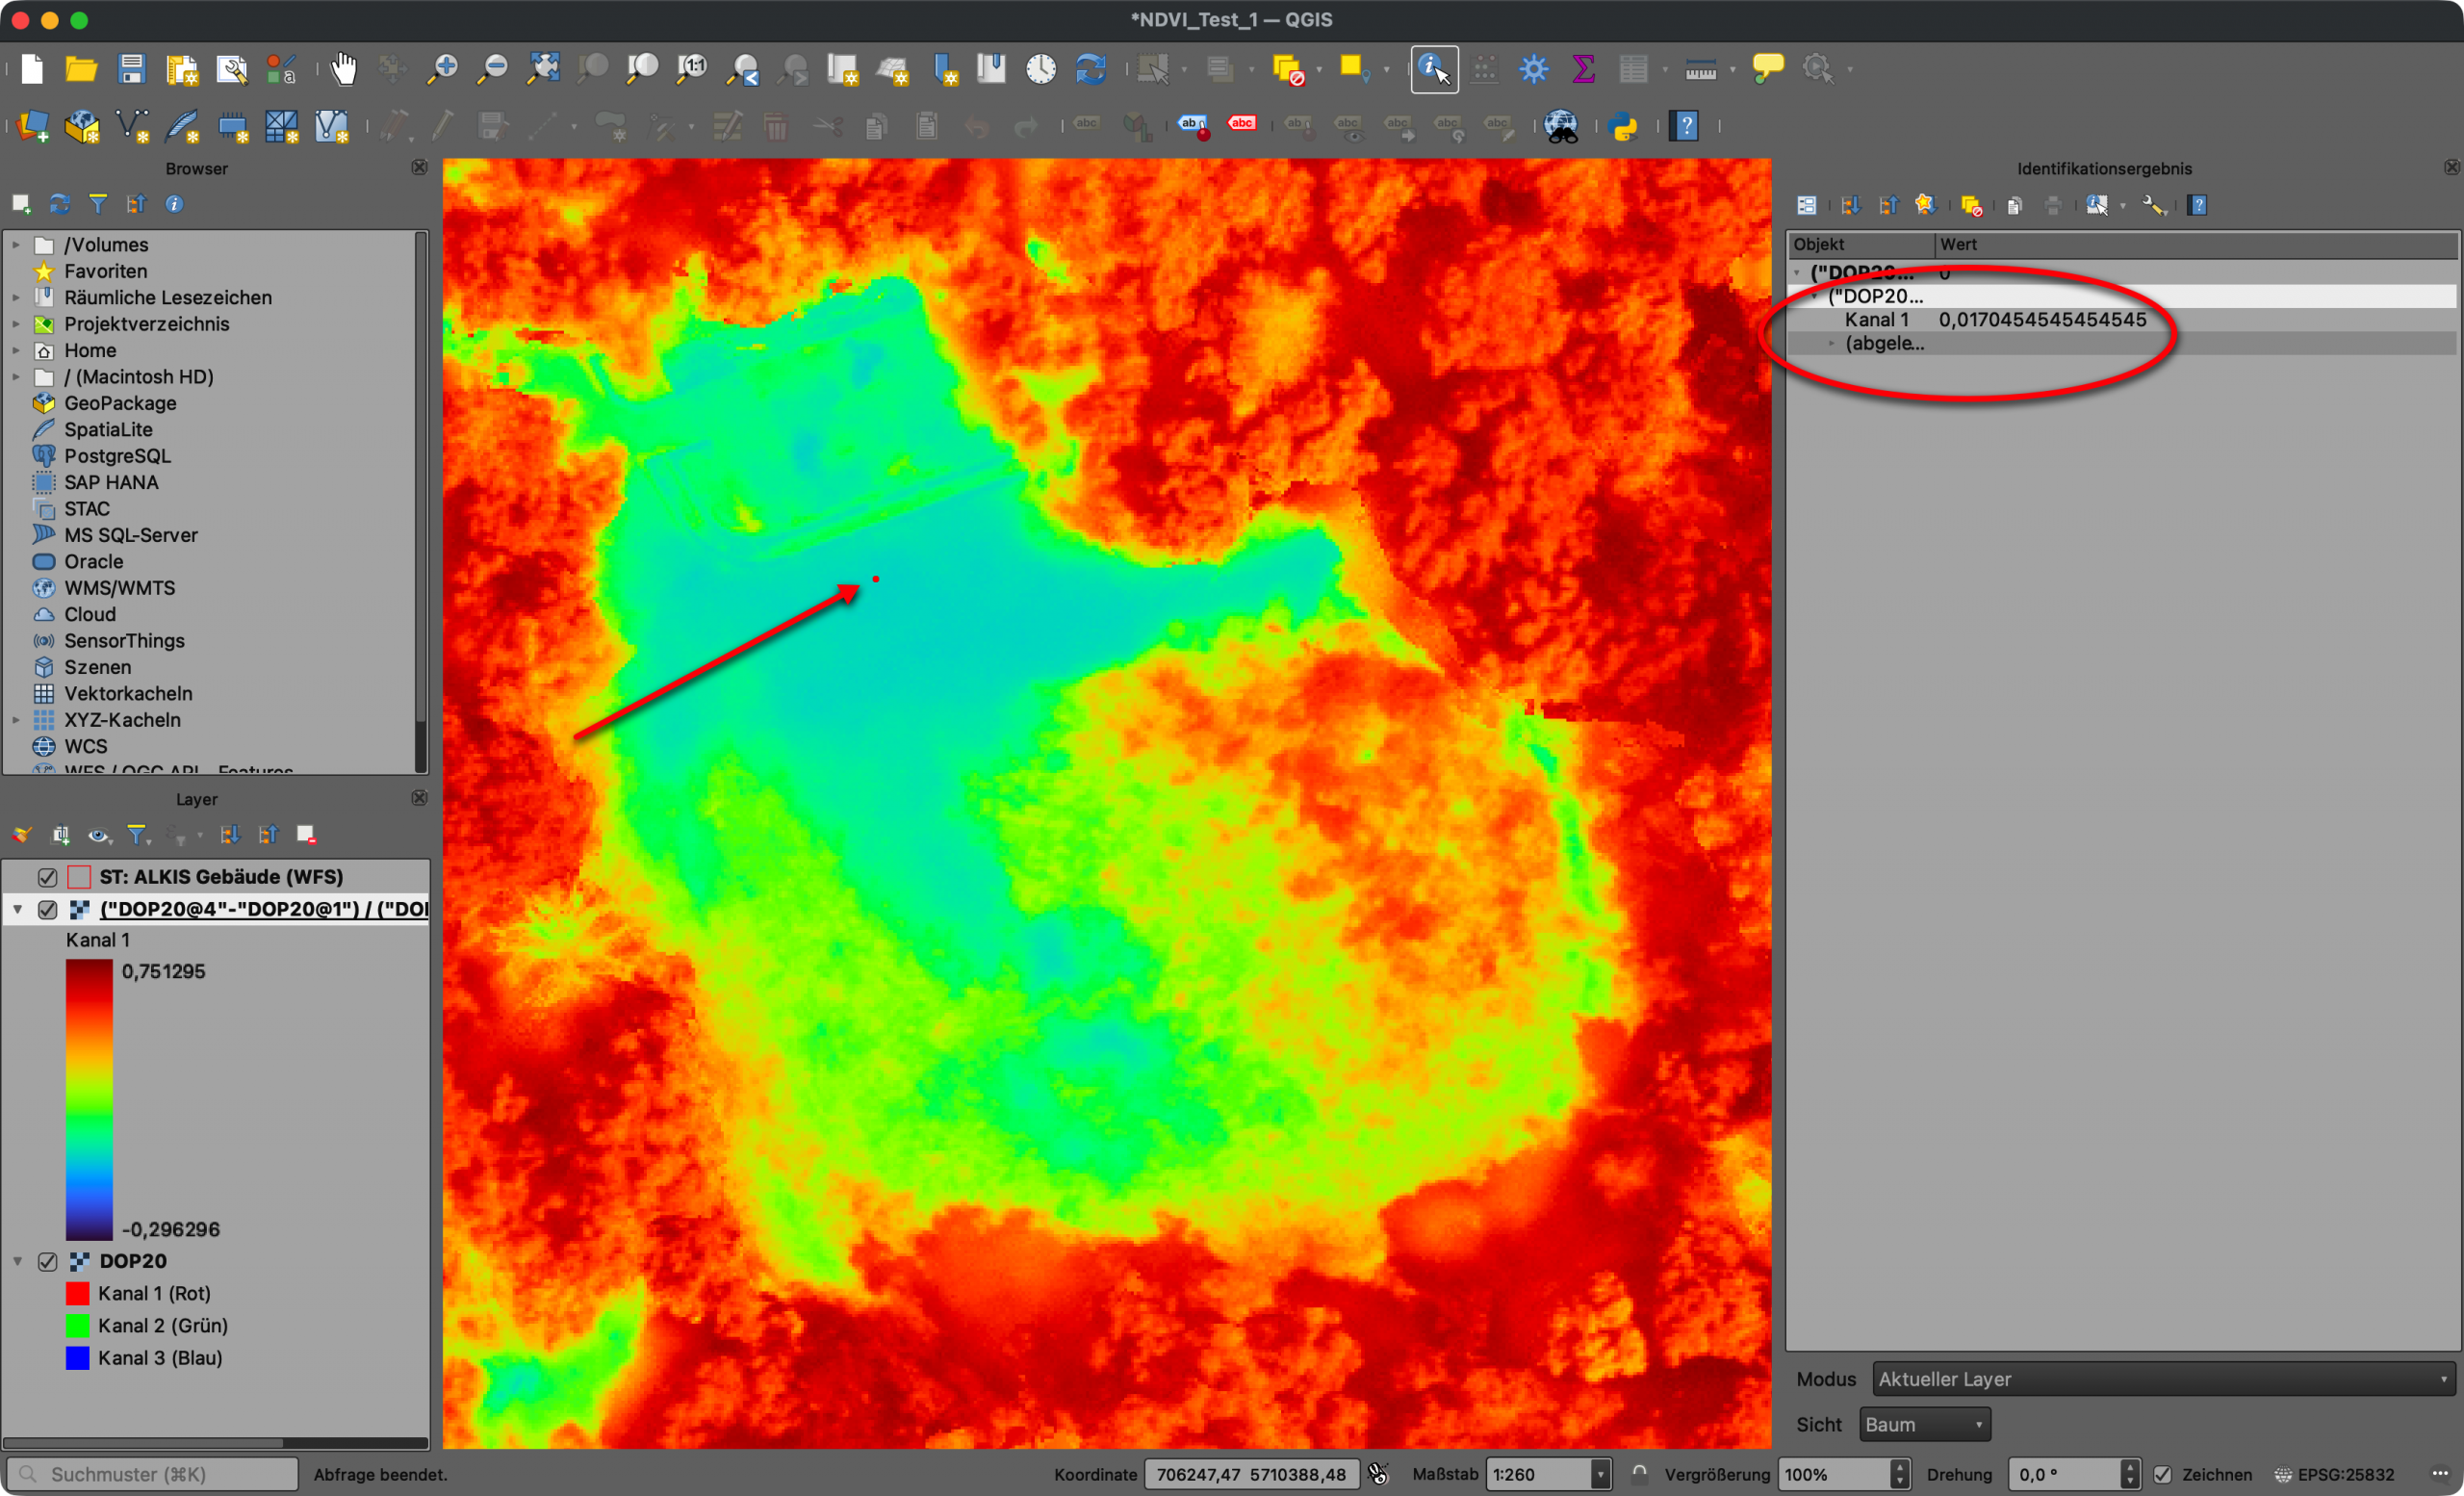
In QGIS kann diese Berechnung unkompliziert mit dem Rasterrechner realisiert werden. Ich habe das mit den vom LVermGeo LSA als freie DOP20-Luftbilder [2] angebotenen Daten getestet. Die Besonderheit hier: die DOP20 repräsentieren im Kanal 4 den benötigten NIR-Kanal. Folgender Screenshot zeigt die Vorgehensweise im QGIS-Rasterrechner mit den LSA-DOPs.
Screenshot 1: Umsetzung der NDVI-Berechnung im QGIS mit dem Ratserrechner
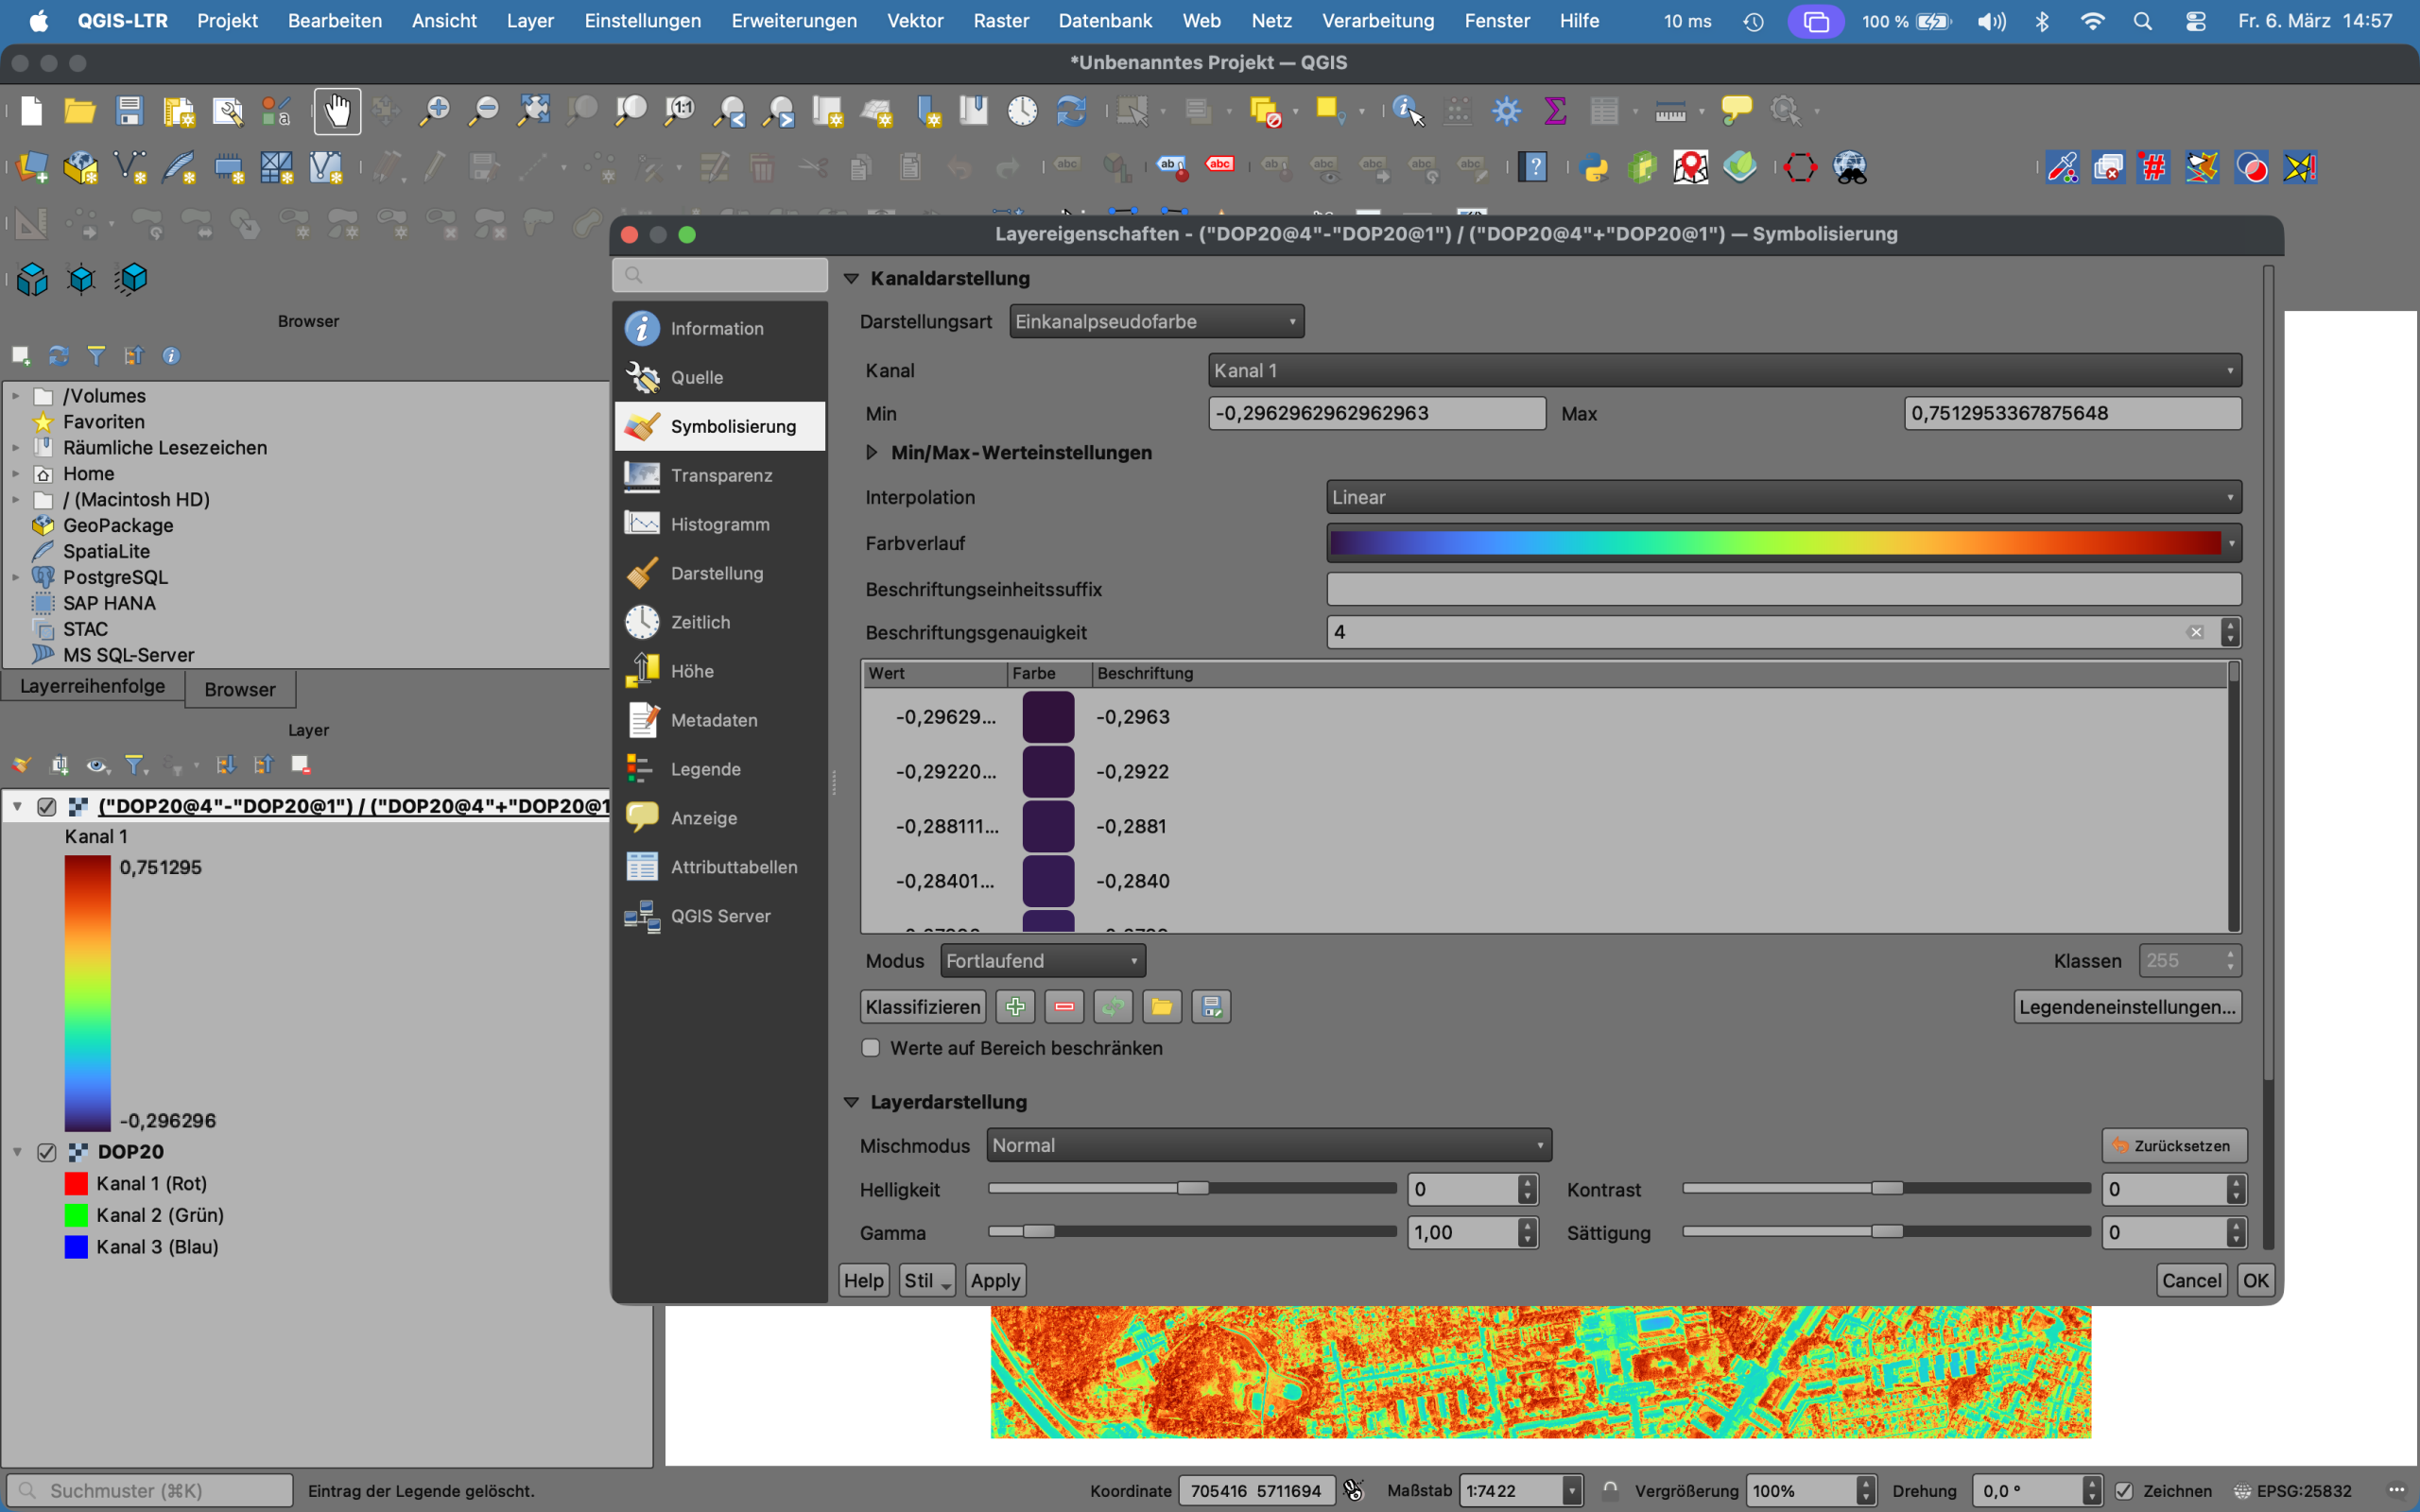
Um das Ergebnis der Berechnung, ein Graustufen-Bild, noch deutlicher zu visualisieren, kann das entstandene Raster z. B. als „Einkanalpseudofarbe“ eingefärbt werden. Die Klassen und Unterschiede im NVDI werden damit deutlich sichtbarer.
Screenshot 2: Einfärben des Graustufen-Ergebnisses als „Einkanalpseudofarbe“ im QGIS
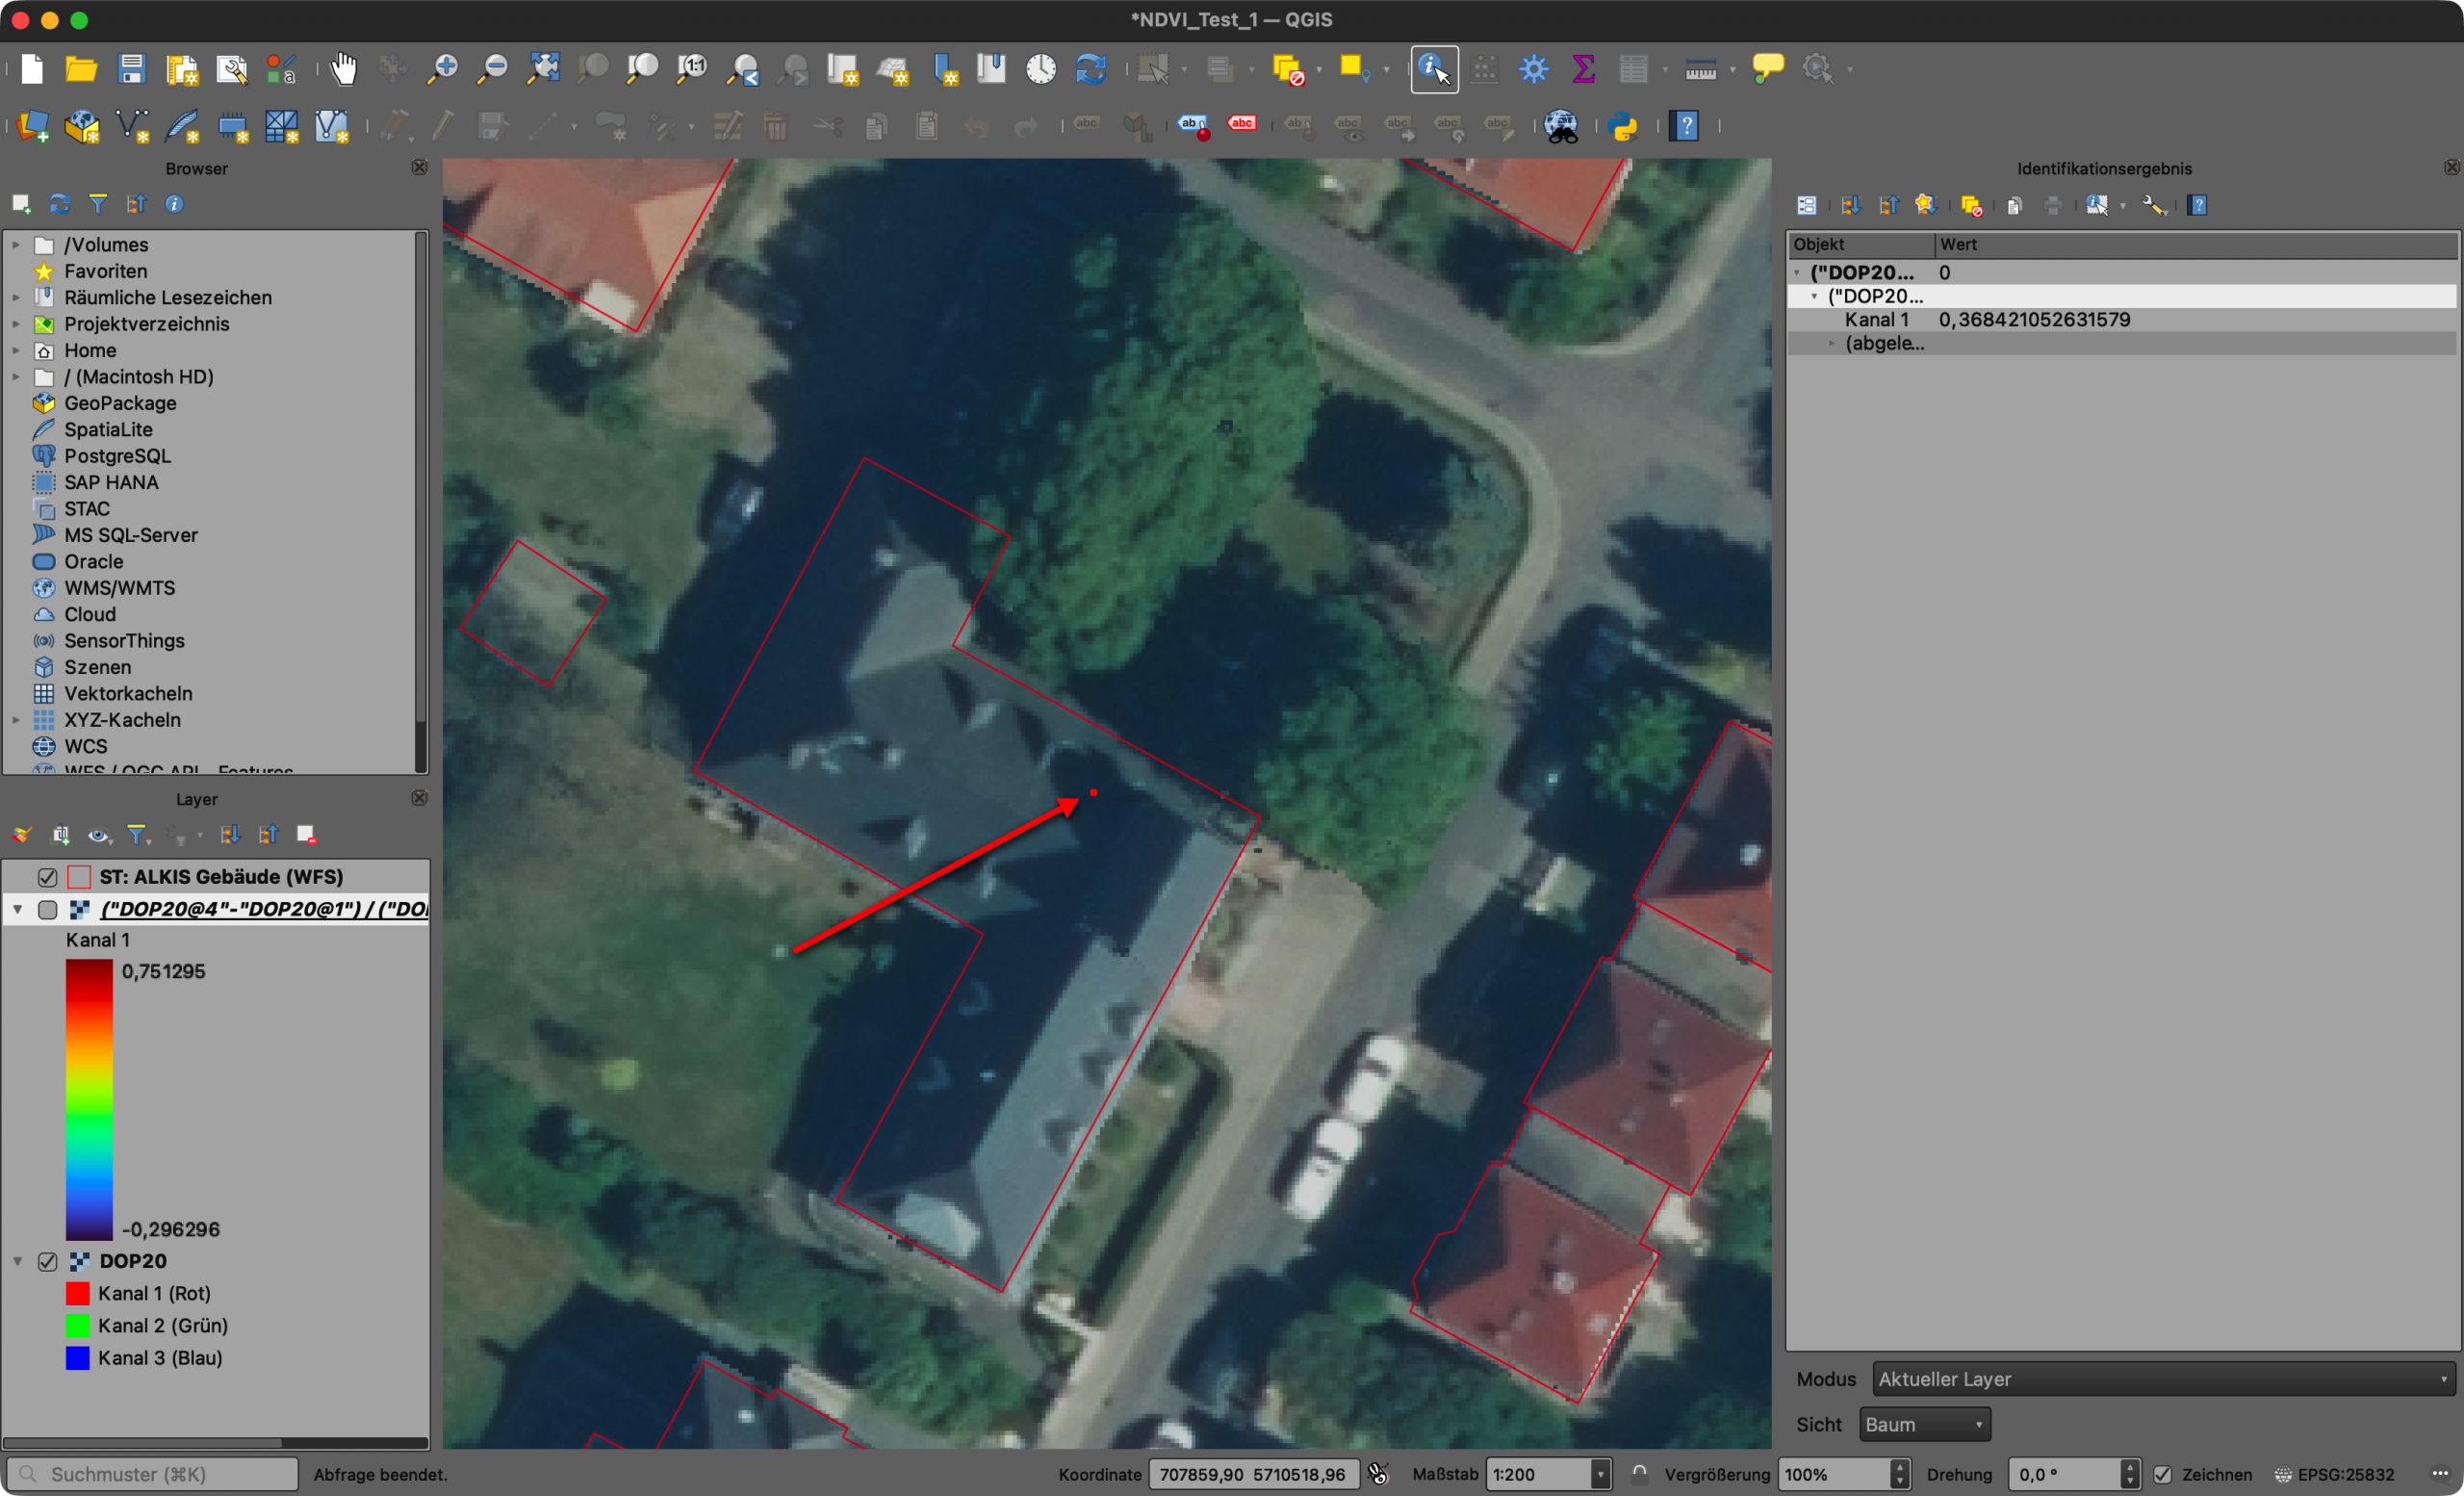
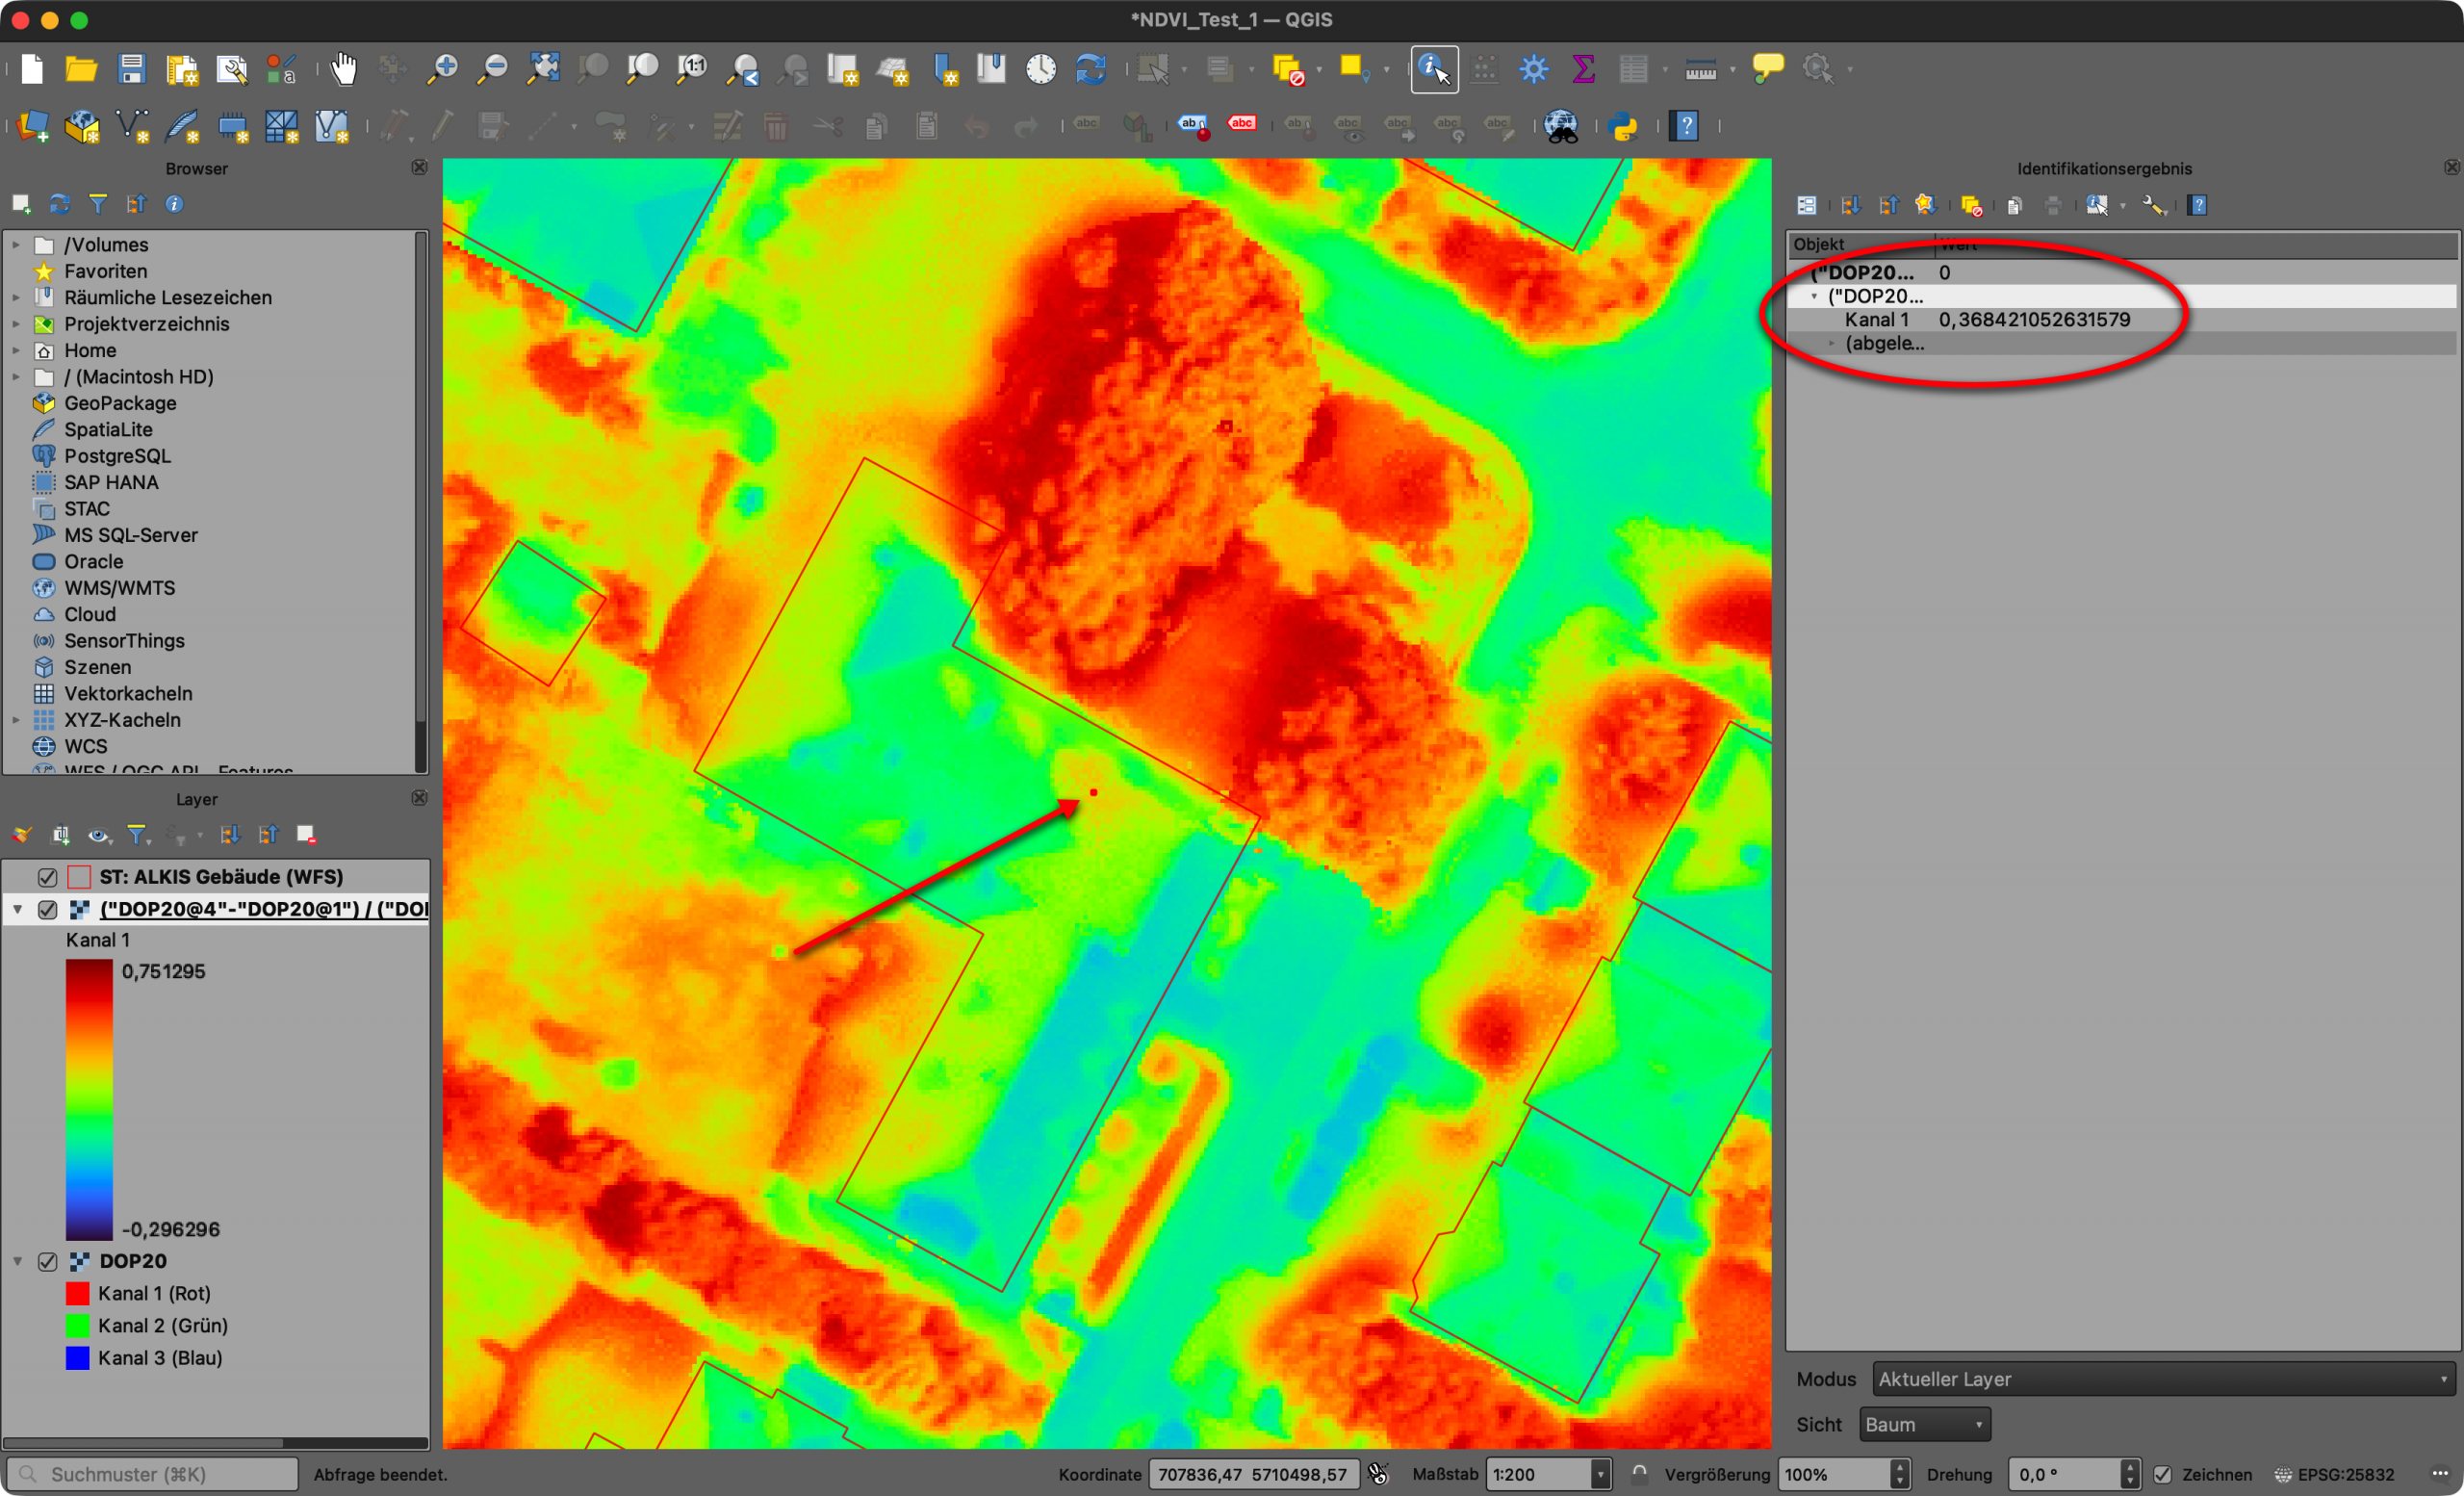
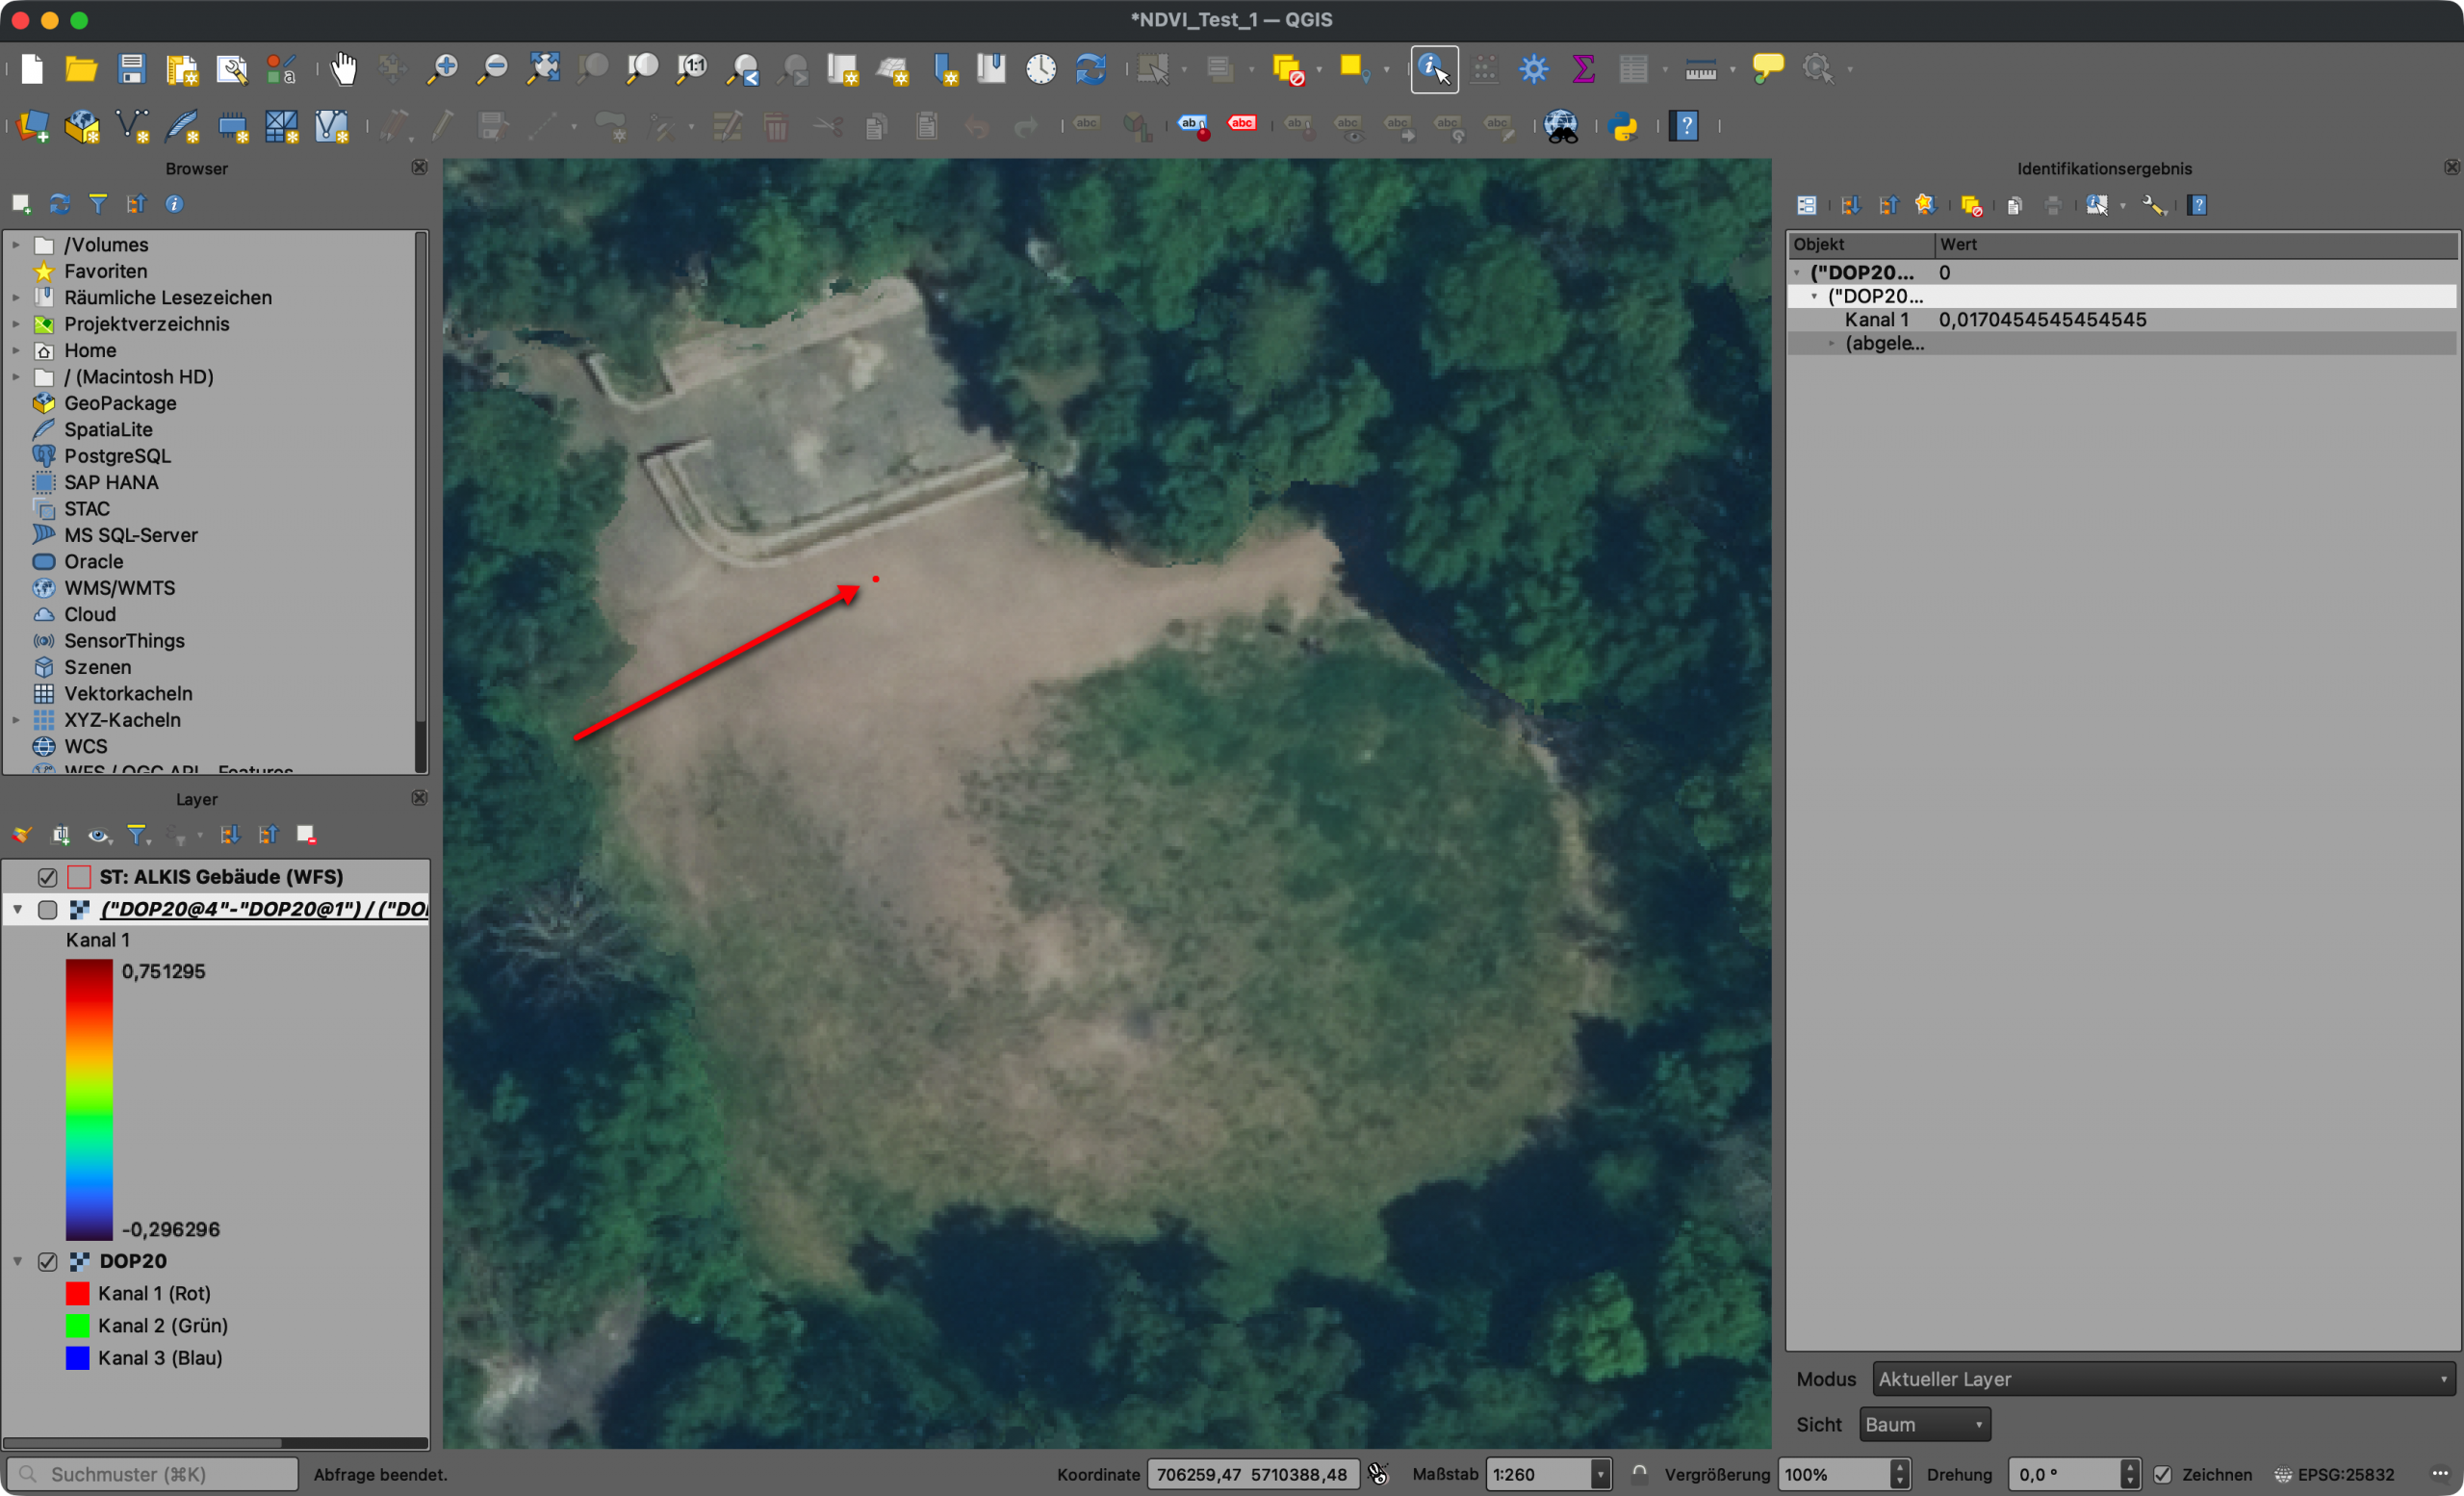
Grenzen und Gefahren bei Fehlinterpretation:
vertrocknete pflanzliche Strukturen (z. B. vertrocknete Rasenfläche)
Screenshot 3: Gefahr der Fehlinterpretation durch Verschattung (hier Verschattung von Dächern)Screenshot 4: Verschattung von Dächern kann dazu führen, dass das Dach teilweise als „Grün“ interpretiert wirdScreenshot 5: Gefahr der Fehlinterpretation durch vertrocknete pflanzliche Strukturen (hier vertrocknete Rasenfläche)Screenshot 6: Die vertrocknete Rasenfläche kann dazu führen, dass sie teilweise als „versiegelt“ interpretiert wird
Danke für den fachlichen Input und das Coaching von M. Sc. Matthias Henning von der Hochschule Anhalt. So muss Netzwerken! Hier noch ein paar wichtige Bemerkungen und Ergänzungen von Matthias bzgl. der Grenzen und Gefahren bei Fehlinterpretation:
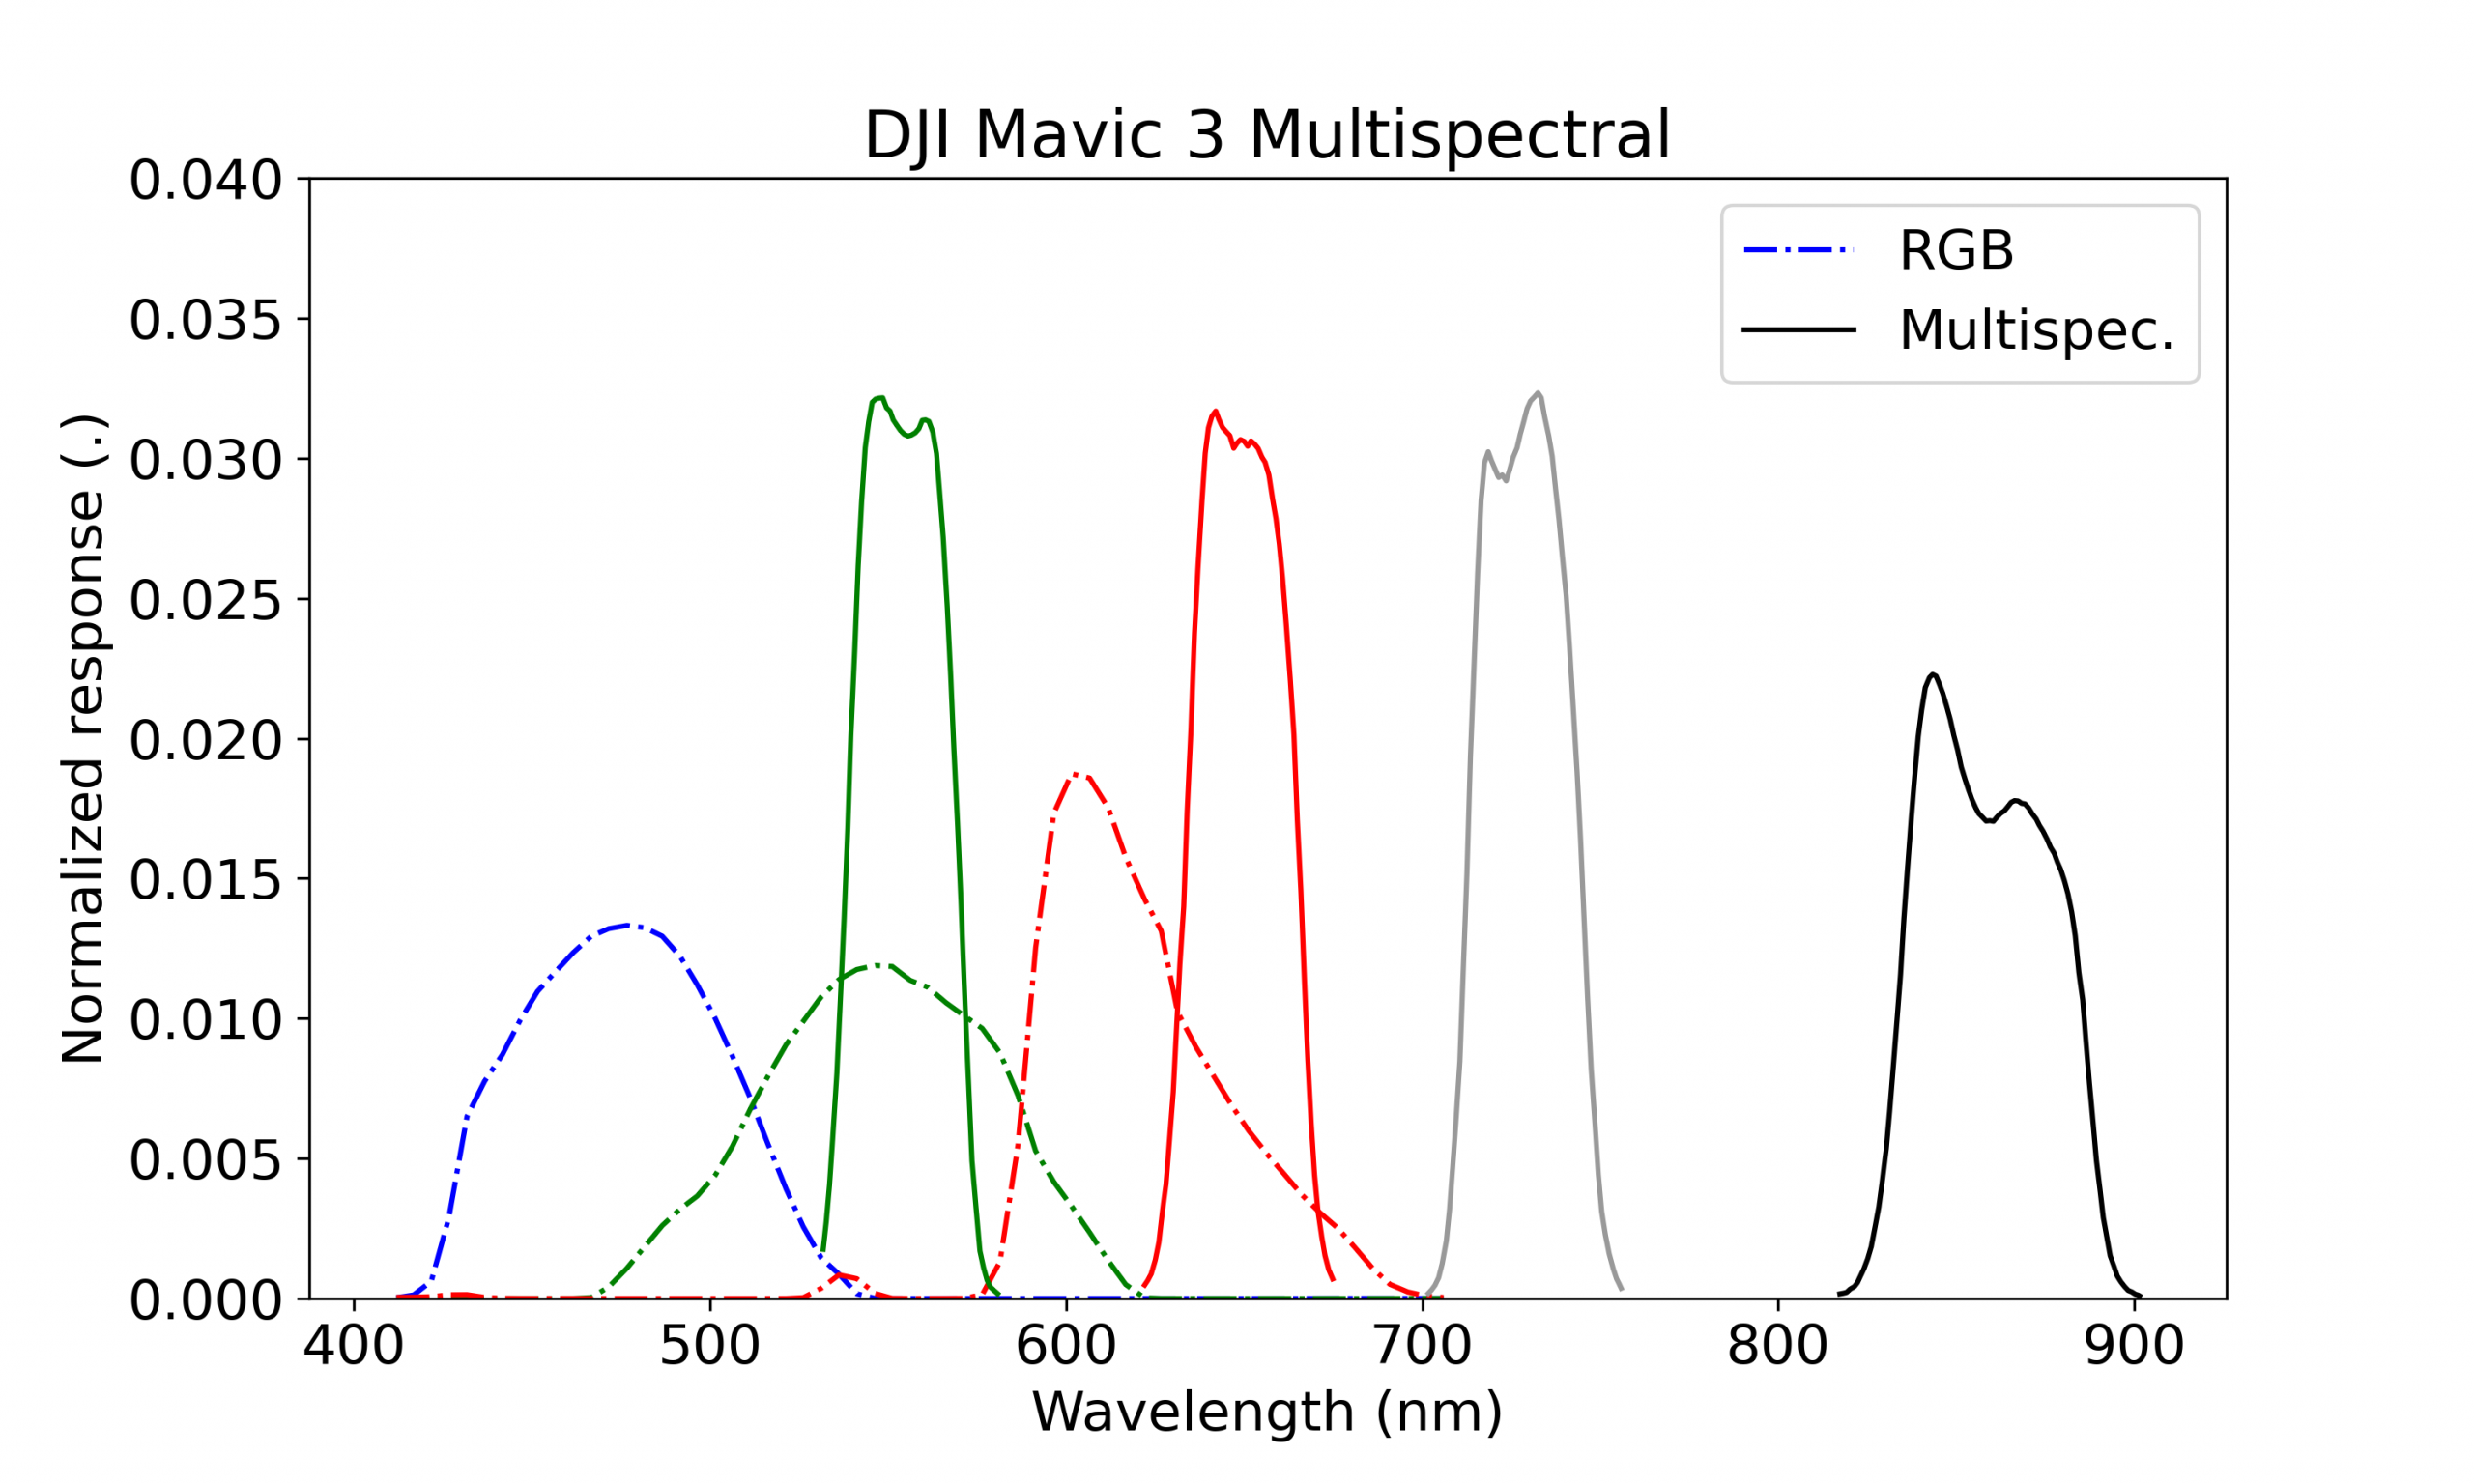
„So gerne und häufig der NDVI auch eingesetzt wird, sollten die Grenzen der jeweiligen Methode immer berücksichtigt werden. Beim NDVI sind diese vor allem bei den Sensoren (Kamera) und den aufgenommenen Lichtspektren zu finden. Einfache Kameras nehmen den NIR-Bereich lediglich als den Bereich wahr, der auf den roten Bereich folgt. Die Intensität der Lichtaufnahme ist bei jedem Kamerasensor unterschiedlich und gleicht einer Kurve. Etwas hochwertigere Kameras steuern die auf den Sensor treffenden Wellenlängenbereiche über einzelne schmalbandigere Filter. Im Bild unten sind die Bereiche der Multispektralkamera der im Einstiegs-UAV-Bereich häufig verwendeten DJI Mavic 3 zu sehen (CC-BY-4.0, Jon Atherton). Diese ordnet die Bereiche des roten und nah-infraroten Spektrums deutlich schmaler zu als z.B. den Rotbereich einer RGB-Kamera. Im Bereich der professionellen Fernerkundung werden diese Wellenlängenbereiche noch viel detaillierter und feiner erfasst. Daher können die NDVI-Werte unterschiedlicher Kamerasysteme nicht ohne weiteres verglichen werden. Ebenso spielen der Sonnenstand, Schattenwürfe, Zentrum der Bildaufnahme, Wuchsrhytmus der Pflanzen, Feuchtigkeit, die Temperaturen und atmosphärische Verzerrungen eine Rolle. Das Licht der Sonne musste immerhin bereits viele Kilometer durch die Atmosphäre zurücklegen, bevor es reflektiert wurde und zum Sensor gelangte. Selbst der Vergleich zweier Aufnahmen desselben Sensors ist daher nicht immer einfach, zumal jedes Sensorsystem teilweise eigene Korrekturen dafür vorsieht. Entweder wird daher der NDVI in jeder Aufnahme kalibriert, indem beispielsweise auf die Werte des vitalsten Baumes normalisiert wird. Oder aber es wird nicht der NDVI, sondern dessen Klassifikation je Aufnahme in verschiedene Vitalitätsklassen, miteinander verglichen.“
Bildquelle: Atherton, J., Alonso Chorda, L., Suomalainen, J., Miettinen, I., Kuurasuo, J., & Hakala, T. (2024). DJI Mavic 3 Multispectral Edition spectral response [Data set]. Zenodo. [3]
Neben NDVI findet Ihr weitere Indizes in folgendem Tweet [4] und der Index DataBase [5].
NDVI, EVI & SAVI are powerful tools in remote sensing, offering insights into vegetation health, density, & distribution.
This infographic highlights their differences in formula, sensitivity, strengths, weaknesses, computational requirements, and ideal use cases. pic.twitter.com/d5lqSjcx1t